Labtrail
Eine UX-Testing-Plattform, die auf eigenen Servern läuft und mit dem ganzen Team in einem Workspace arbeitet.
- Art
- Side-Project, Self-hosted-Werkzeug für UX-Research
- Rolle
- Produkt, UX und UI, Umsetzung mit KI-Unterstützung (Claude Code)
- Zeitraum
- Oktober bis November 2026, erster Commit am 7.10., aktueller Stand vom 8.11.
- Plattform
- Web-App für das Research-Team, Teilnehmer-App für Desktop und Smartphone
- Technik
- Next.js, React, TypeScript, PostgreSQL mit Row-Level Security, Docker
Kurzfassung
Für unmoderierte Usability-Tests habe ich mit einem kommerziellen Tool gearbeitet und bin an drei Stellen an Grenzen gestoßen: Die Kosten waren für die Menge an Tests zu hoch, die Daten der Testpersonen lagen bei einem fremden Anbieter, und die Zusammenarbeit im Team lief nicht so, wie ich sie mir vorgestellt hatte. Jeder weitere Platz im Team kostete extra, Studien hingen an der Person, die sie angelegt hatte, und die Ergebnisse ließen sich nur umständlich weitergeben.
Ich habe deshalb eine eigene Plattform gebaut, die ich an meine Arbeitsweise anpassen und erweitern kann. Studien bestehen aus Bausteinen: einer Aufgabe in einem Figma-Prototyp, einem Erster-Klick-Test, einem 5-Sekunden-Test oder einem Fragebogen. Die Designfrage dahinter lautete: Wie wird ein Testwerkzeug so ehrlich, dass man seinen Zahlen glauben kann, ohne jede Sitzung einzeln anzusehen?
Das Problem
Ein Testtool liefert Zahlen, auf deren Grundlage ein Team Designentscheidungen trifft. Das stellt drei Anforderungen:
- Kosten: Wer regelmäßig testet, braucht ein Werkzeug, das nicht pro Studie oder pro Testperson teurer wird.
- Kontrolle über die Daten: Klicks, Antworten und Zeiten von Testpersonen sind personenbezogene Daten im weiteren Sinn. Ich wollte wissen, wo sie liegen und wann sie gelöscht werden.
- Zusammenarbeit: Mehrere Personen bauen Studien, andere schauen nur auf die Ergebnisse. Rollen, gemeinsame Bilder und eine geteilte Auswertung gehören zum Kern, nicht in einen teureren Tarif.
Bei der Zusammenarbeit hakte es im Alltag an drei Stellen:
- Bezahlte Plätze: Jede weitere Person im Team kostete extra. Also hatten nur wenige Zugang, und alle anderen bekamen Screenshots der Ergebnisse statt der Auswertung selbst. Nachfragen wie „Wo genau wurde auf diesem Screen geklickt?“ landeten wieder bei mir.
- Studien hingen an einer Person: Wer eine Studie angelegt hatte, besaß sie. War diese Person nicht da, kamen die anderen schlecht an die Studie und ihre Ergebnisse.
- Ergebnisse weitergeben war Handarbeit: Teilen ging nur über das Tool selbst, der Export war knapp. Für Präsentationen und eigene Auswertungen habe ich Zahlen von Hand übertragen.
Dazu kam der Wunsch, das Werkzeug an die eigene Arbeitsweise anzupassen: eigene Testabläufe, eigene Auswertungen, später neue Methoden. Bei einem gemieteten Tool geht nur, was der Anbieter vorsieht.
Der Gedanke, der das Design bestimmt hat
Bei Testtools ist die bequemste Zahl oft die freundlichste. Eine Trefferquote sieht besser aus, wenn man Personen herausrechnet, die „Weiß ich nicht“ gewählt haben. Eine Erfolgsquote sieht besser aus, wenn der Browser der Testperson selbst meldet, dass das Ziel erreicht wurde.
Daraus wurde das Leitprinzip: Jede Zahl muss so berechnet sein, dass sie im Zweifel gegen das getestete Design spricht, und sie muss nachvollziehbar sein.
Schlüsselentscheidungen
Entscheidung 1
Eine Studie ist eine Liste von Bausteinen
Statt fester Testtypen besteht jede Studie aus einer geordneten Liste von Blöcken: Begrüßung, Aufgaben, Fragen, Danke-Screen. So lassen sich Methoden kombinieren, etwa eine Prototyp-Aufgabe mit anschließendem SUS-Fragebogen.
Technisch hat jeder Blocktyp genau eine Beschreibung, die Builder, Teilnehmer-App und Auswertung gemeinsam nutzen. Eine neue Testmethode braucht deshalb keinen Umbau der Datenbank. Das ist wichtig, weil Card Sorting und Tree Testing als Nächstes kommen.
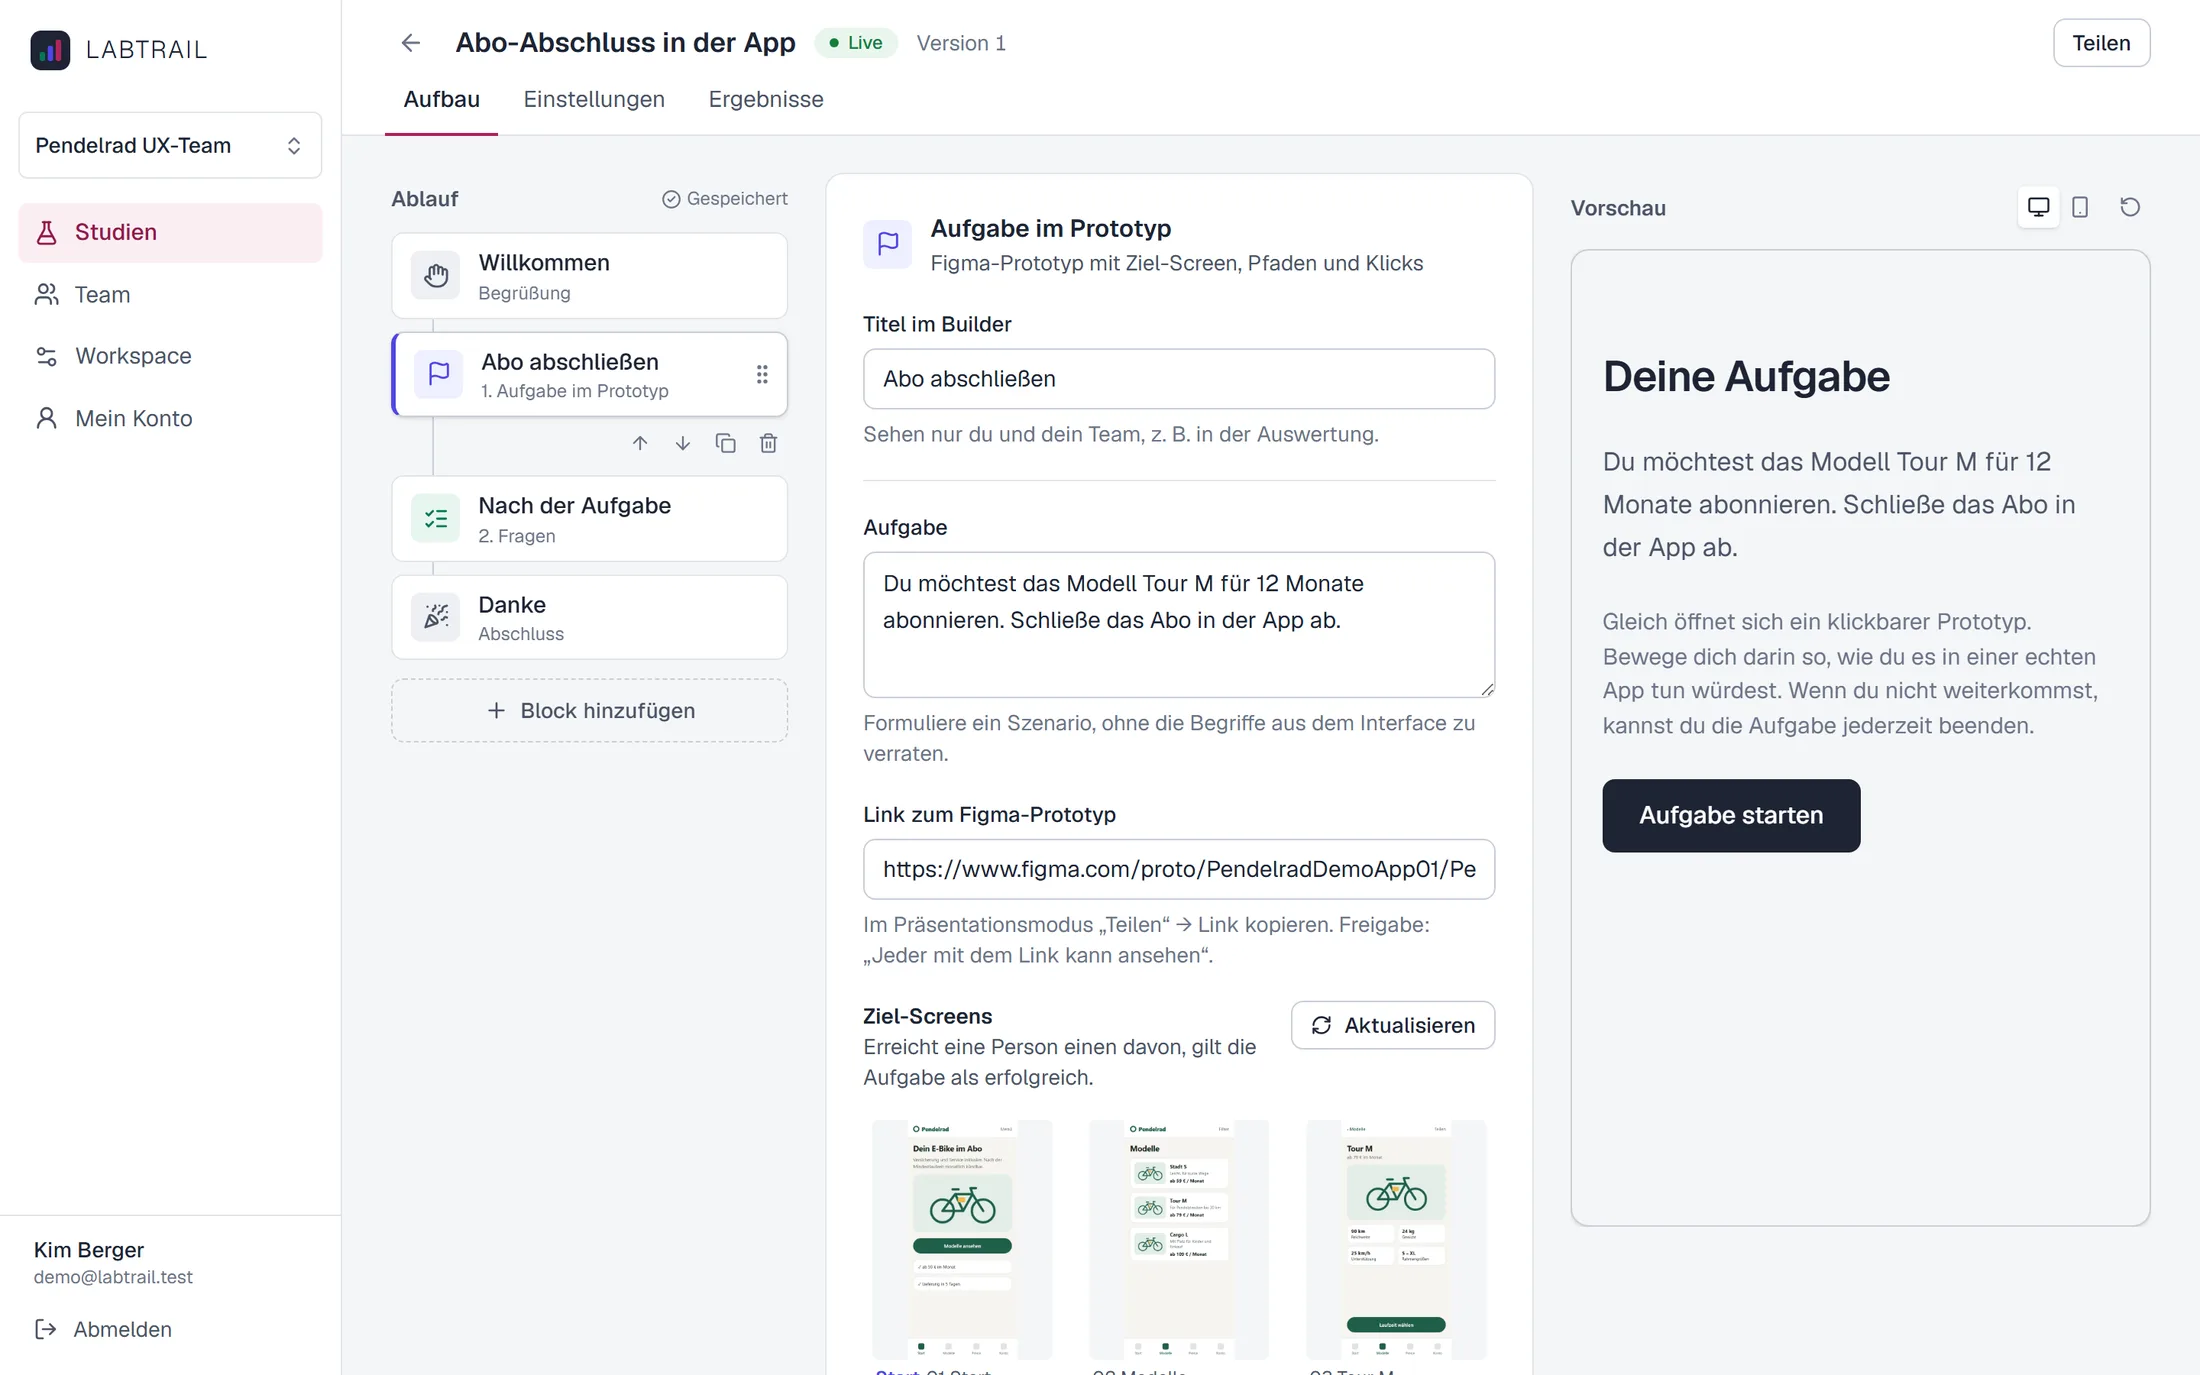
Entwürfe dürfen unvollständig sein. Erst beim Veröffentlichen prüft die App alles und friert die Studie als Version ein. Ergebnisse gehören immer zu genau einer Version, damit eine nachträgliche Änderung nicht still die Bedeutung alter Antworten verschiebt.
Entscheidung 2
Echte Figma-Prototypen statt Screenshot-Strecken
Viele Tools zerlegen Prototypen in Einzelbilder mit Klickflächen. Animationen, Overlays und Zustände gehen dabei verloren, und Testpersonen erleben etwas anderes als das Design. Labtrail bettet den Figma-Prototyp deshalb direkt ein. Vor dem Bau habe ich in einem kleinen Spike geprüft, dass das auch für Testpersonen ohne Figma-Konto funktioniert.
Der Preis dafür: Die Schnittstelle meldet Screen-Wechsel und Klicks, aber keine Mausbewegungen. Und Klickpositionen kommen relativ zum angeklickten Element, nicht zum Screen. Die App speichert deshalb die Rohdaten und rechnet sie erst in der Auswertung mit den Layer-Positionen aus Figma auf den Screen um. Wird die Umrechnung später verbessert, gilt das auch für alte Studien.
Entscheidung 3
Der Server entscheidet, ob eine Aufgabe gelöst ist
Die Teilnehmer-App läuft im Browser fremder Menschen und ist damit nicht vertrauenswürdig. Sie meldet nur, was passiert ist: welche Screens, welche Klicks, wie lange. Ob das Ziel erreicht wurde oder ein Klick in einem Zielbereich lag, berechnet der Server aus der veröffentlichten Version der Studie.
Das schützt nicht nur vor Manipulation, sondern auch vor eigenen Fehlern: Ändert sich die Teilnehmer-App, bleibt die Bewertung dieselbe.
Entscheidung 4
„Weiß ich nicht“ zählt als nicht gefunden
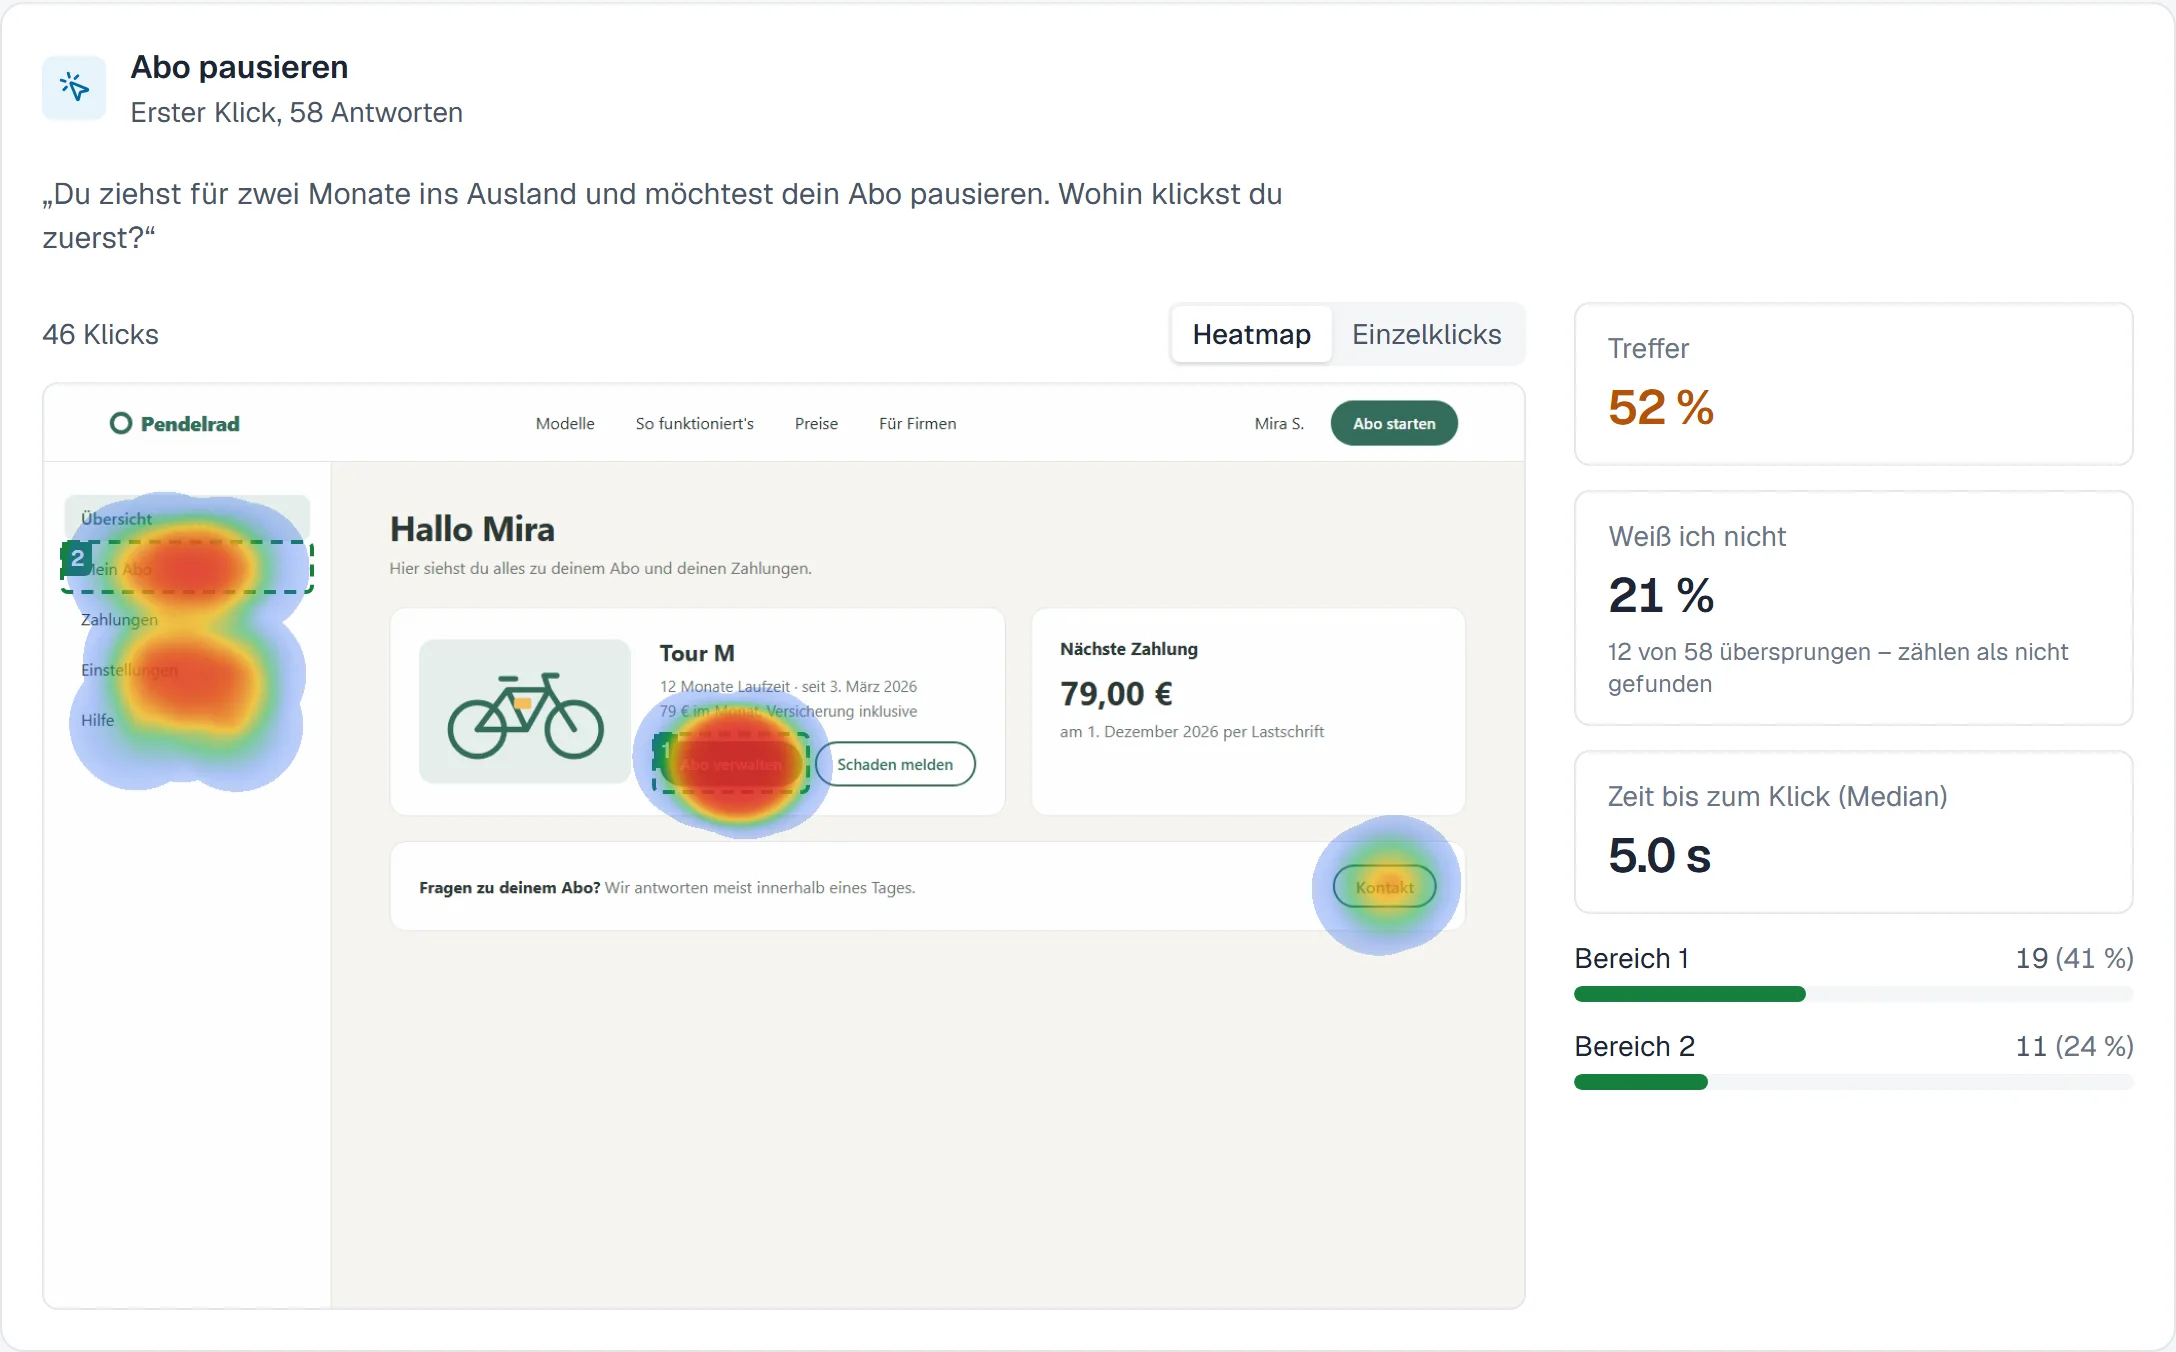
Beim Erster-Klick-Test können Testpersonen „Weiß ich nicht“ wählen. Das verhindert geratene Klicks, die das Ergebnis verfälschen. In der Trefferquote zählen diese Antworten aber als nicht gefunden und werden zusätzlich ausgewiesen. Würde man sie herausrechnen, stiege die Quote im Beispiel von 52 % auf 65 %, genau die freundliche Zahl, die das Leitprinzip verhindern soll.
Entscheidung 5
Datenschutz als Teil des Ablaufs
Datenschutz ist hier keine Einstellung, sondern im Ablauf verankert:
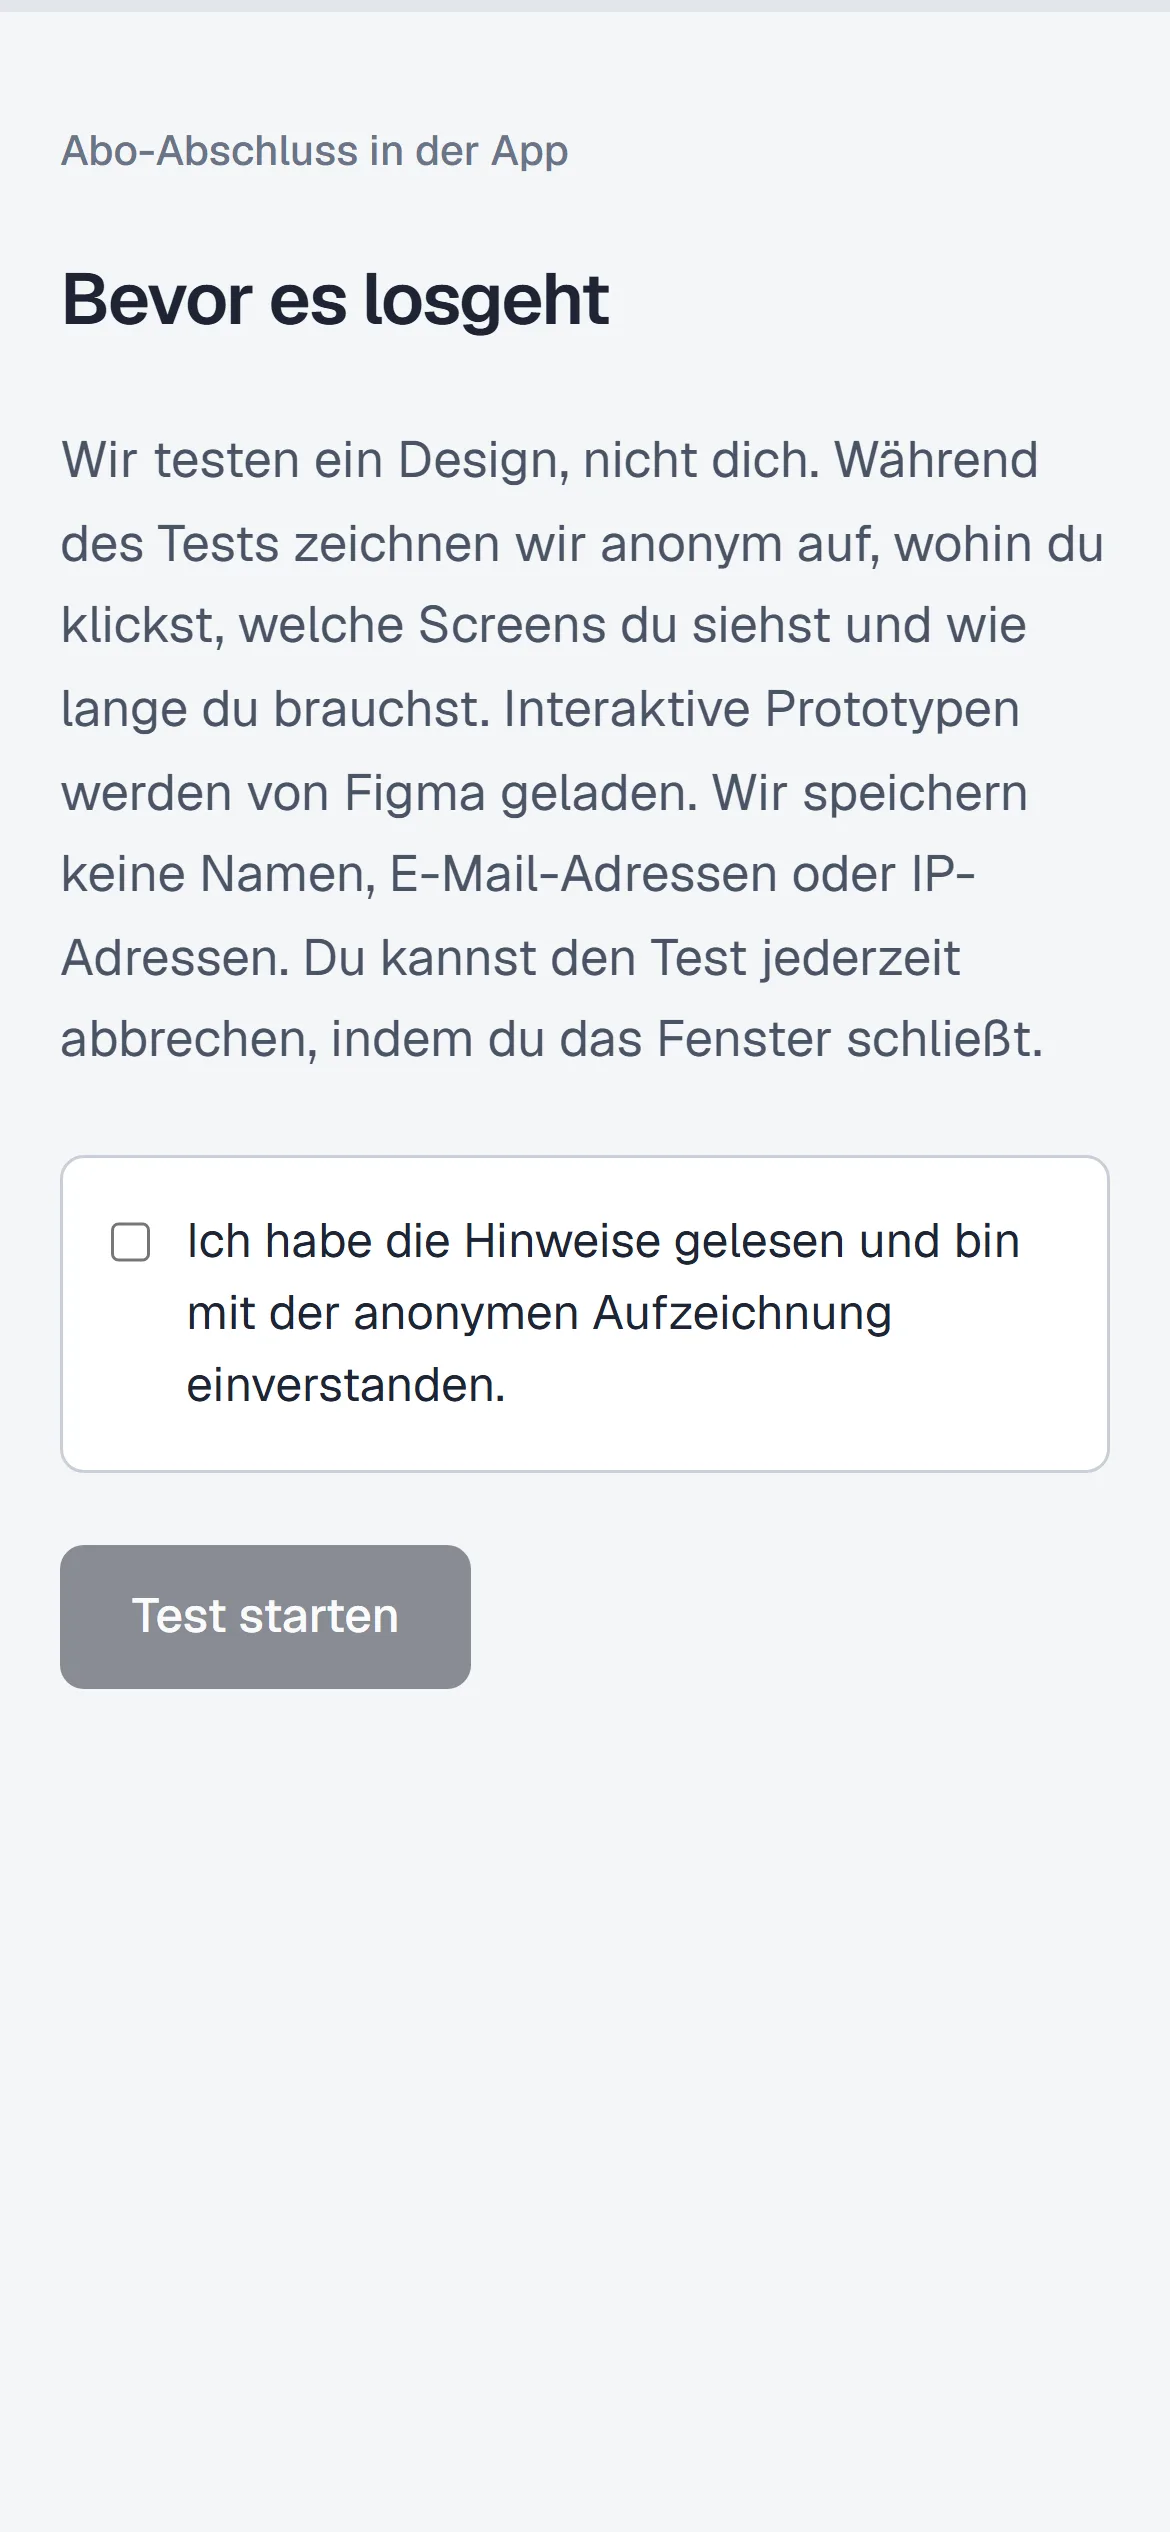
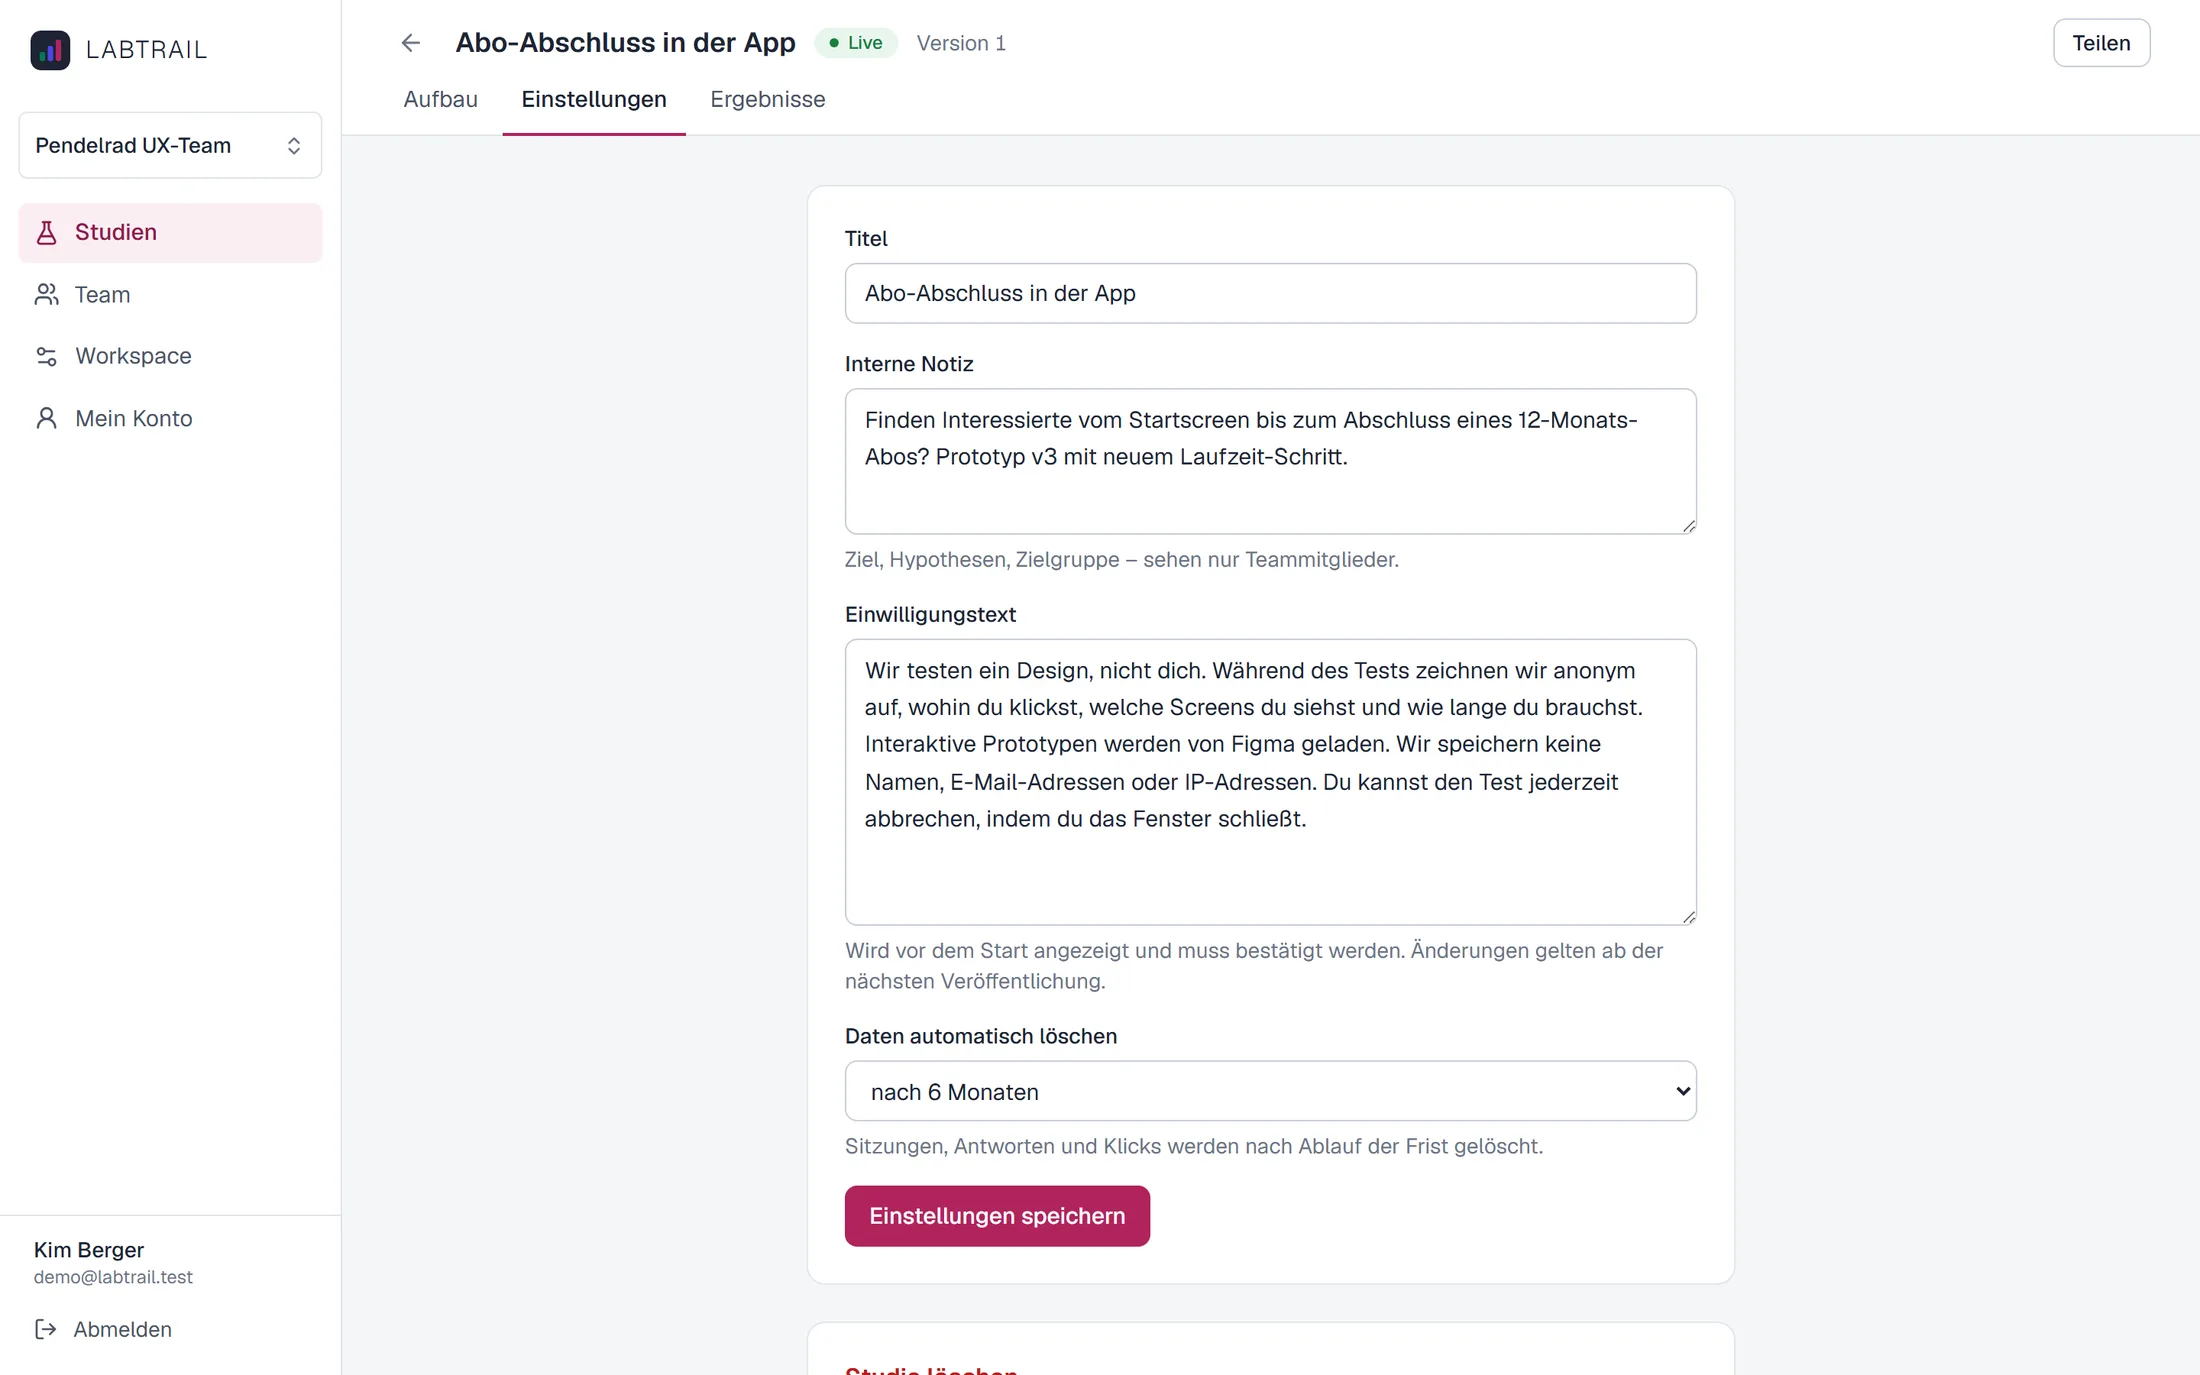
- Einwilligung vor dem Start: Ohne Häkchen startet kein Test. Der Text ist pro Studie anpassbar und wird mit der Version eingefroren.
- Pseudonyme Sitzungen: Keine Namen, keine E-Mail-Adressen, keine IP-Adressen. Die einzige externe Verbindung ist der eingebettete Figma-Prototyp, und die Einwilligung sagt das.
- Löschfristen pro Studie: Sitzungen, Antworten und Klicks werden nach Ablauf automatisch gelöscht.
Entscheidung 6
Zusammenarbeit in Workspaces, sauber getrennt
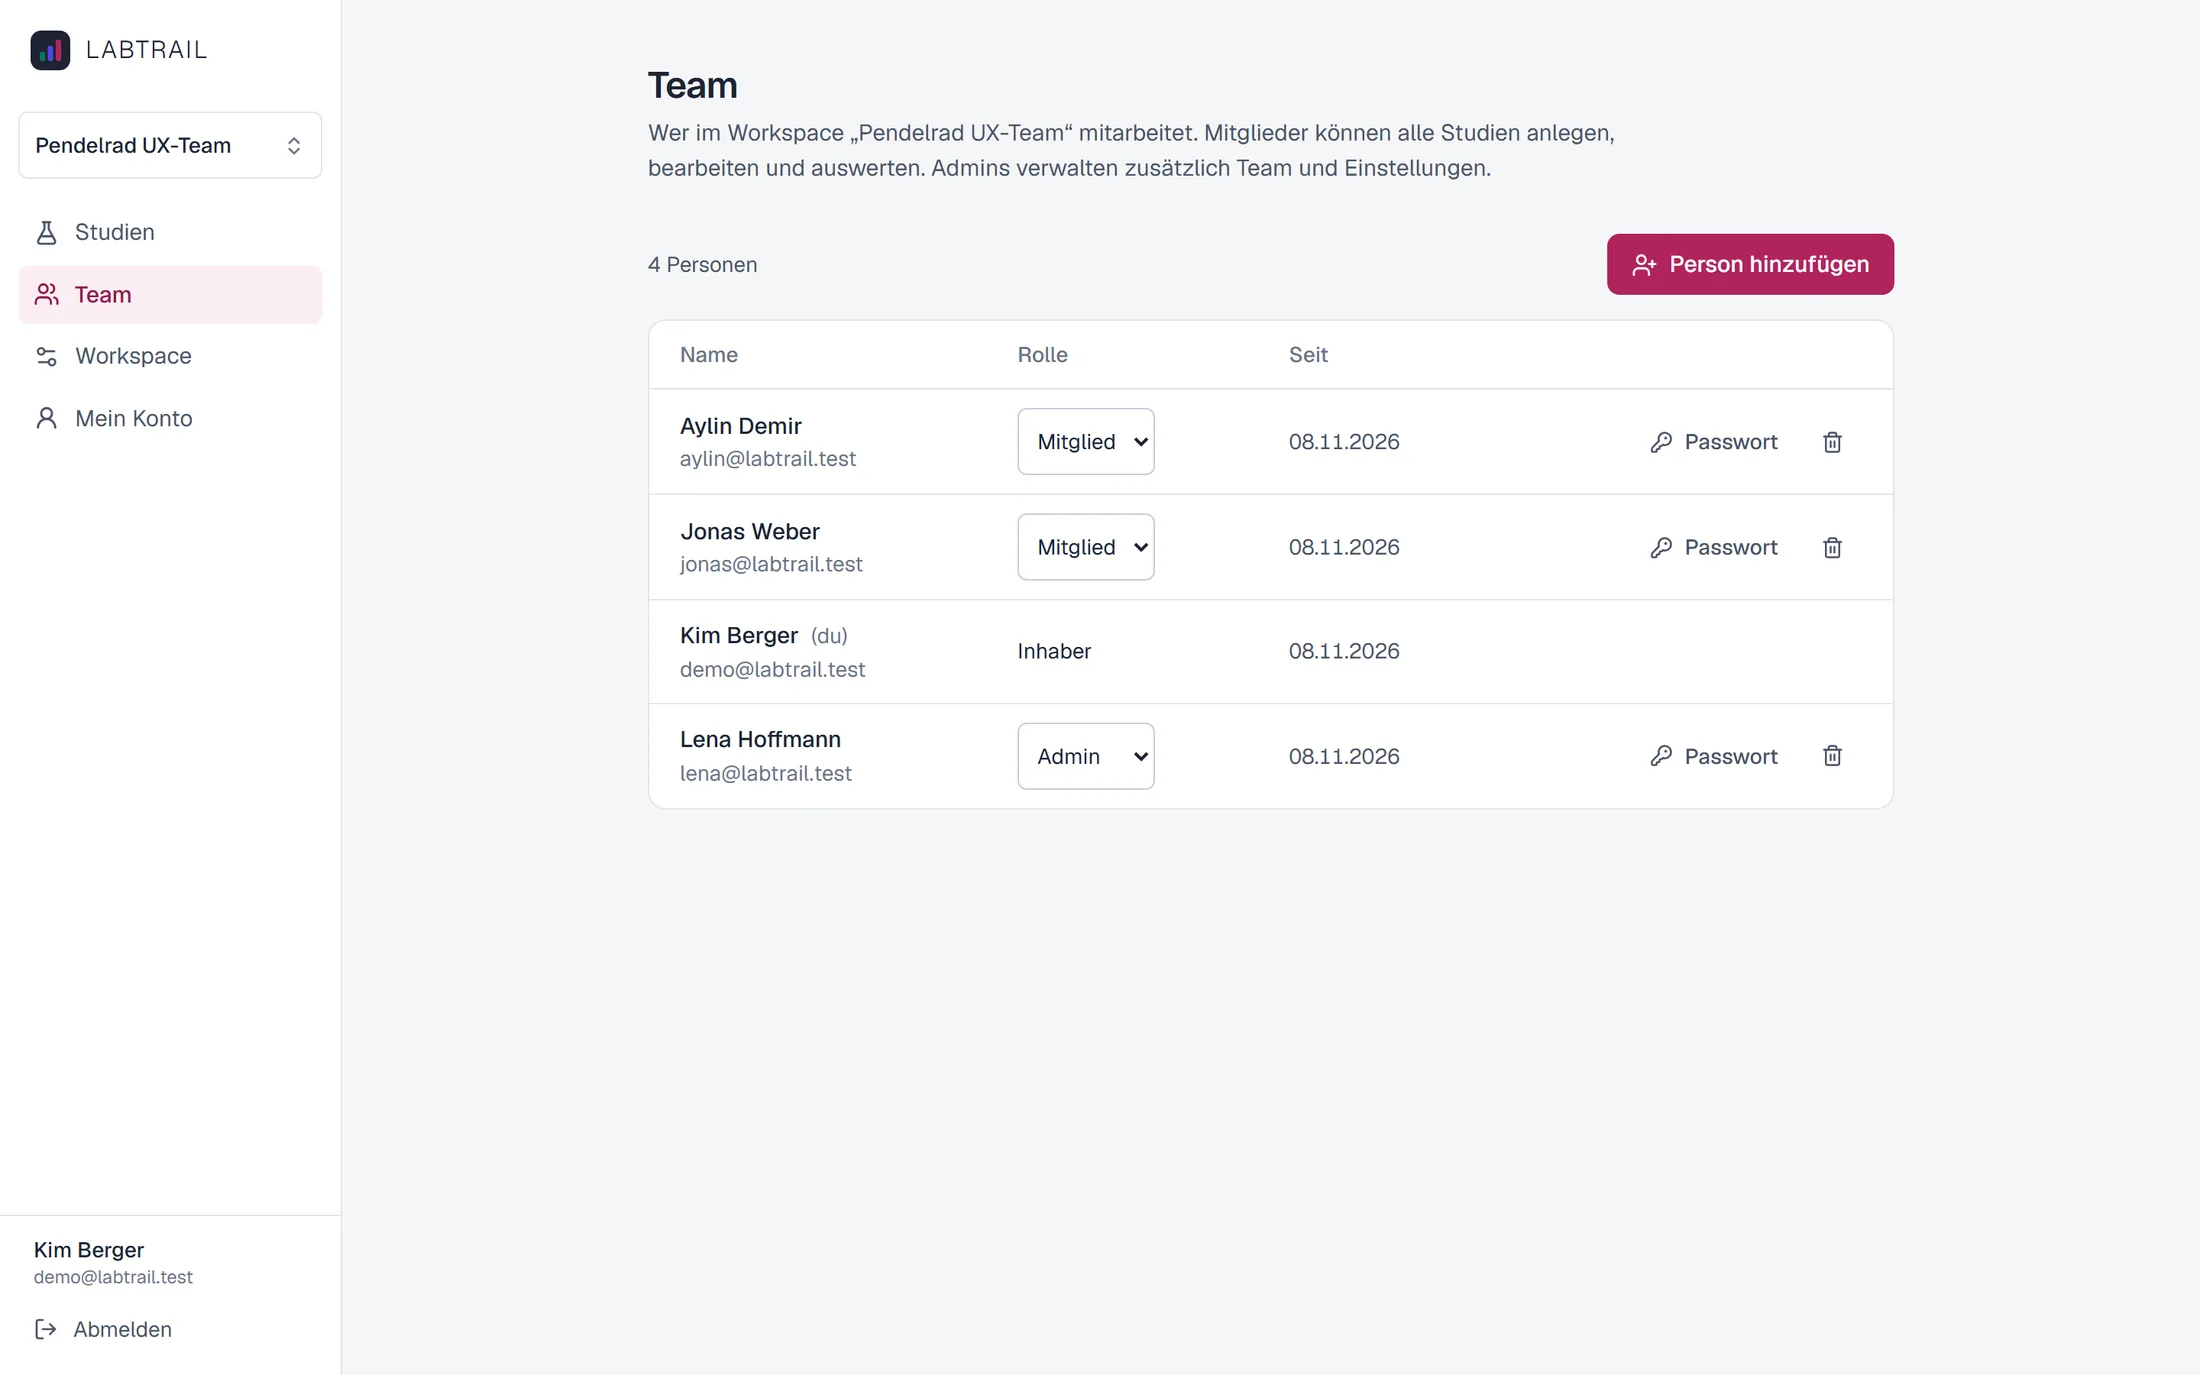
Ein Team arbeitet in einem Workspace mit den Rollen Owner, Admin und Mitglied. Die Antworten auf die drei Probleme von oben:
- Keine Platzlizenzen: Ein Workspace hat so viele Mitglieder wie nötig. Wer nur Ergebnisse ansehen will, bekommt einen eigenen Zugang statt eines Screenshots.
- Studien gehören dem Team: Jede Studie liegt im Workspace, nicht bei der Person, die sie angelegt hat. Alle Mitglieder können sie bearbeiten und auswerten. Team und Einstellungen verwalten nur Owner und Admins.
- Ergebnisse als Rohdaten: Jede Version einer Studie lässt sich als CSV oder als JSON mit allen Sitzungen, Antworten und Klicks exportieren, etwa für eine Tabelle, eine Präsentation oder eine eigene Auswertung.
Mehrere Teams, Produkte oder Kunden bekommen jeweils einen eigenen Workspace. Damit die Plattform das sicher kann, trennt die Datenbank die Workspaces selbst: Jede Abfrage läuft mit einer eingeschränkten Datenbankrolle, und Postgres liefert nur Zeilen des aktiven Workspaces aus, auch wenn eine Abfrage den Filter vergisst. Ein Test schlägt fehl, sobald eine neue Tabelle ohne diese Regel angelegt wird.
Entscheidung 7
Die Teilnehmer-App ist für Menschen gebaut, die nichts über UX wissen
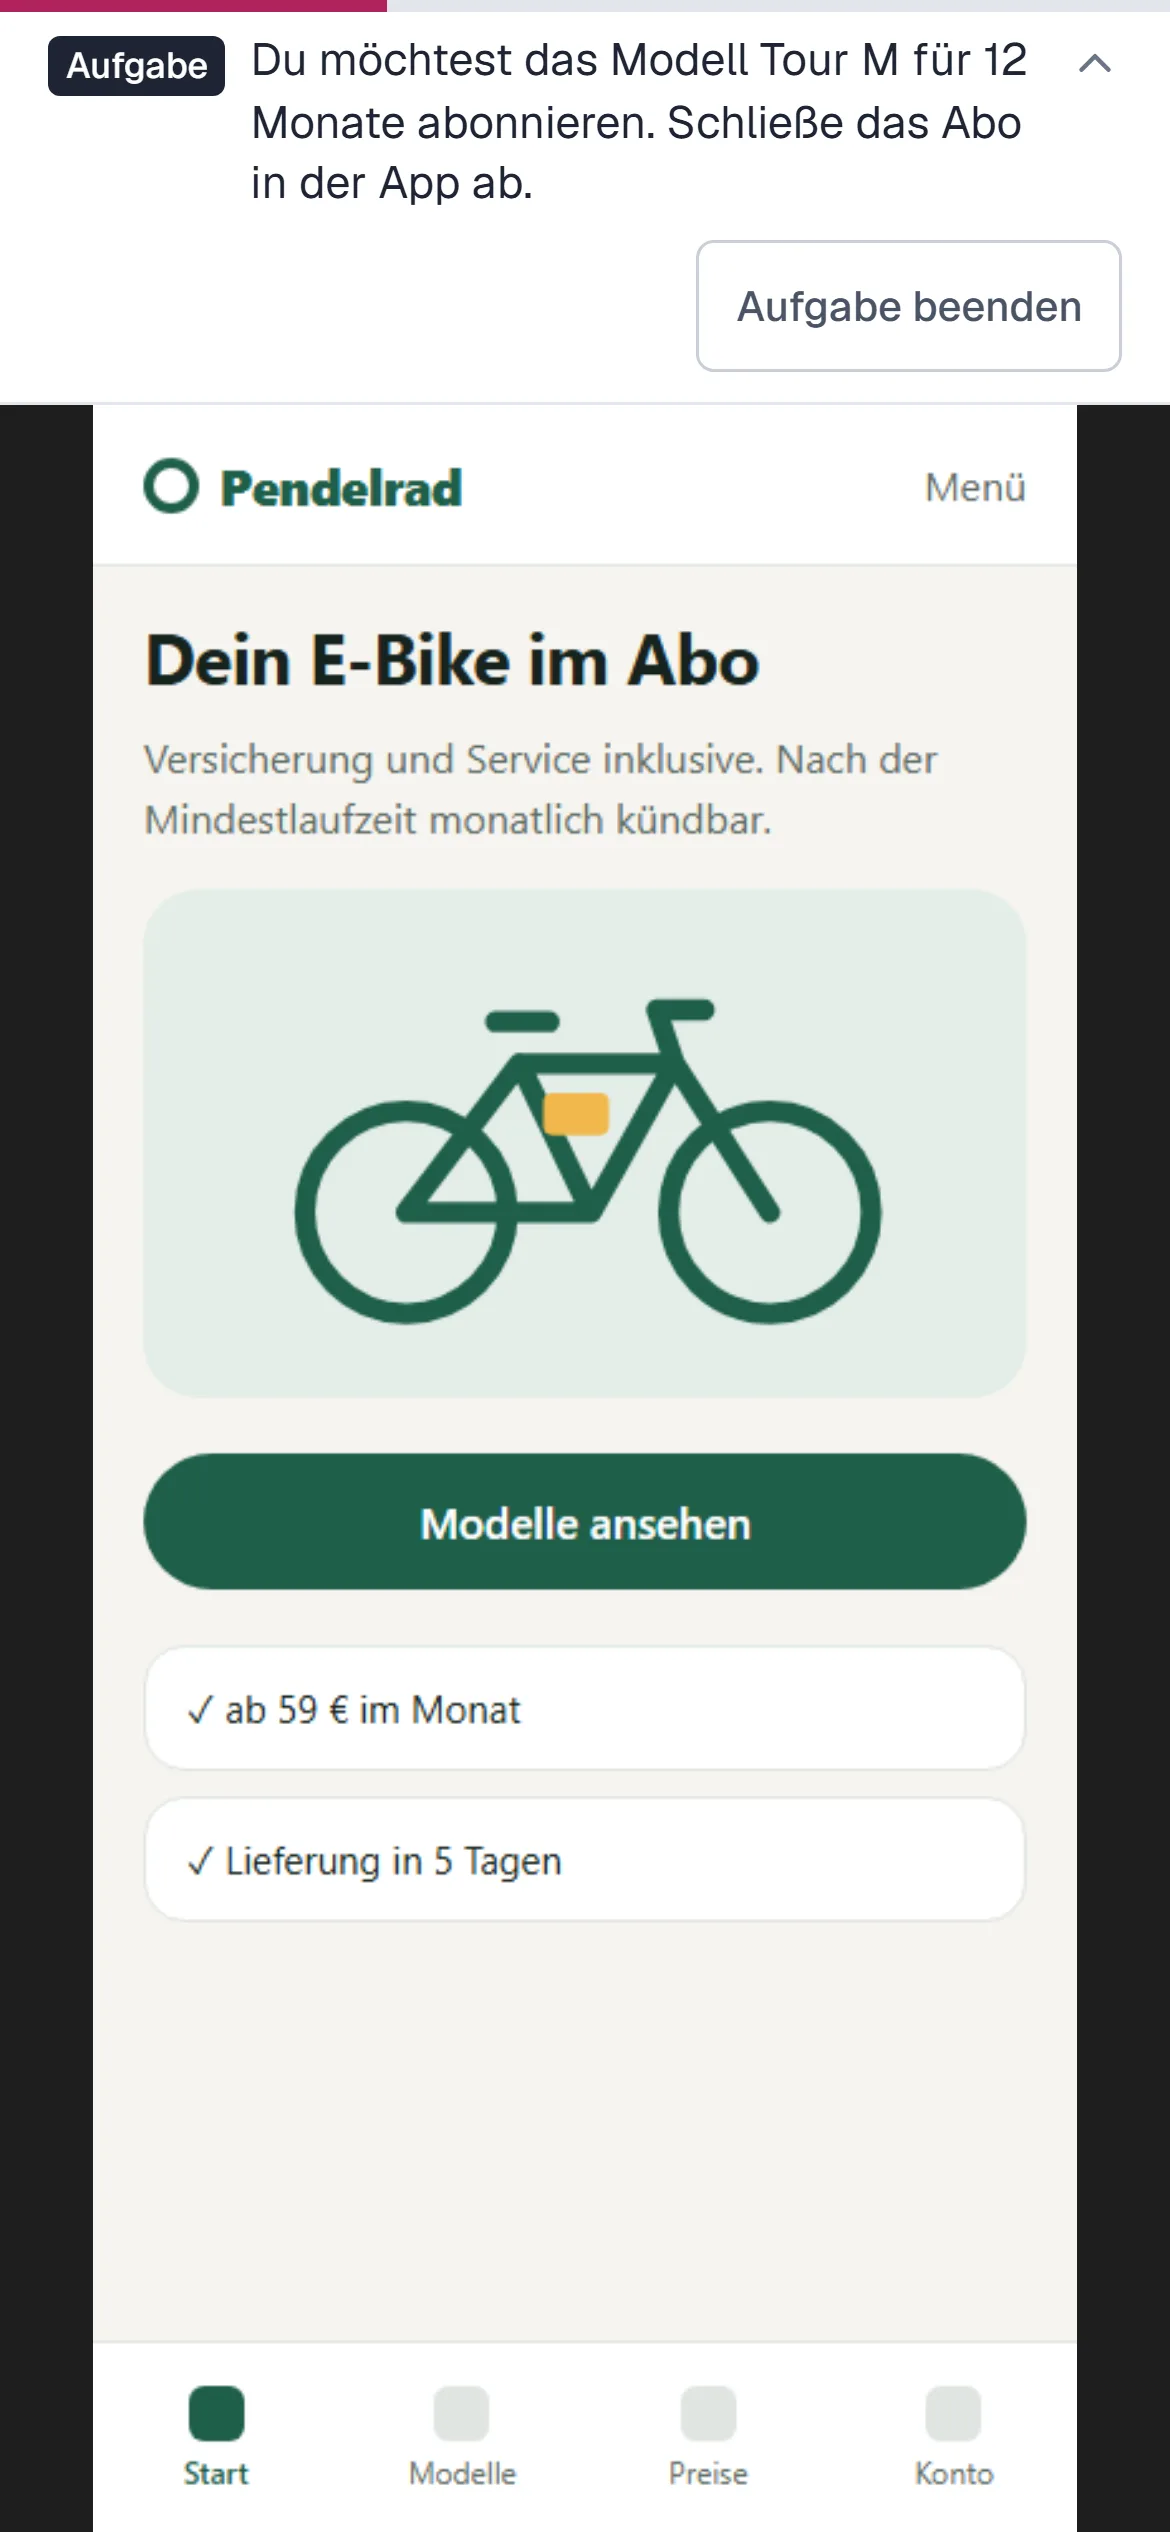
Testpersonen sehen keine Fachbegriffe, sondern Sätze in Du-Form. Alle Bedienelemente sind per Tastatur erreichbar, Touch-Ziele mindestens 44 px groß, und die Aufgabe bleibt während des Tests einklappbar oben sichtbar.
Beim Erstellen der Screenshots für diese Seite fiel mir auf, dass der Aufgabentext auf schmalen Smartphones in eine schmale Spalte gedrückt wurde, weil der Button „Aufgabe beenden“ daneben zu viel Platz brauchte. Jetzt rutscht der Button bei Platzmangel in eine eigene Zeile.
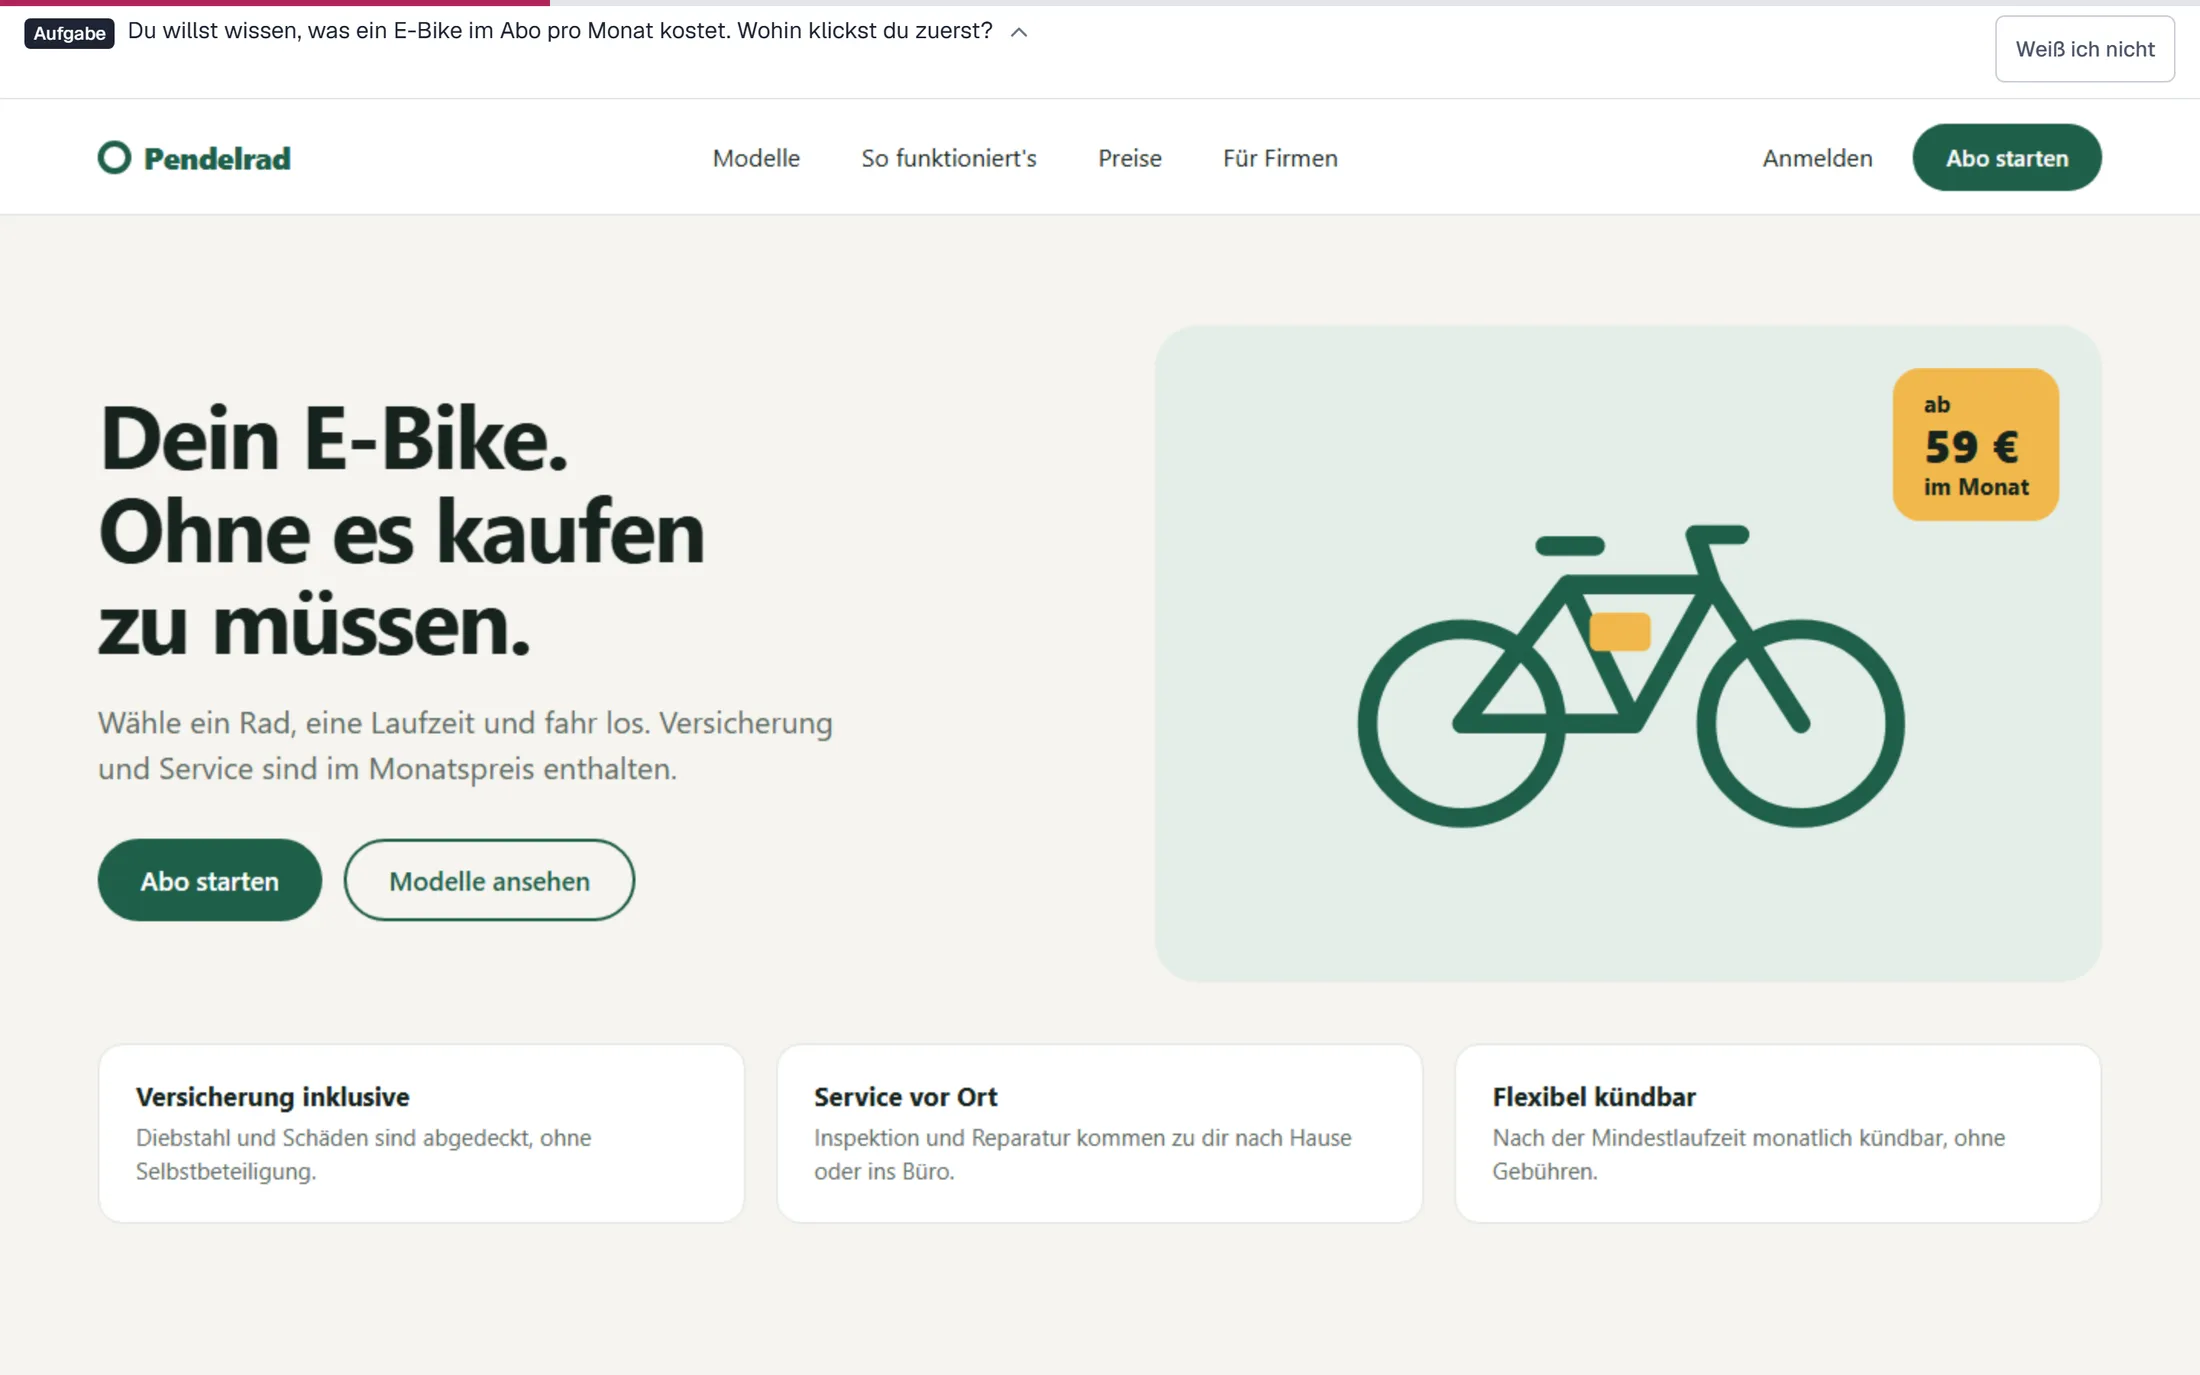
Die Demo: eine erfundene Marke, simulierte Testpersonen
Für diese Seite gibt es keine echten Studiendaten, die ich zeigen könnte. Ich habe deshalb eine fiktive Marke angelegt, „Pendelrad“, ein E-Bike-Abo, und drei Studien mit simulierten Teilnehmenden:
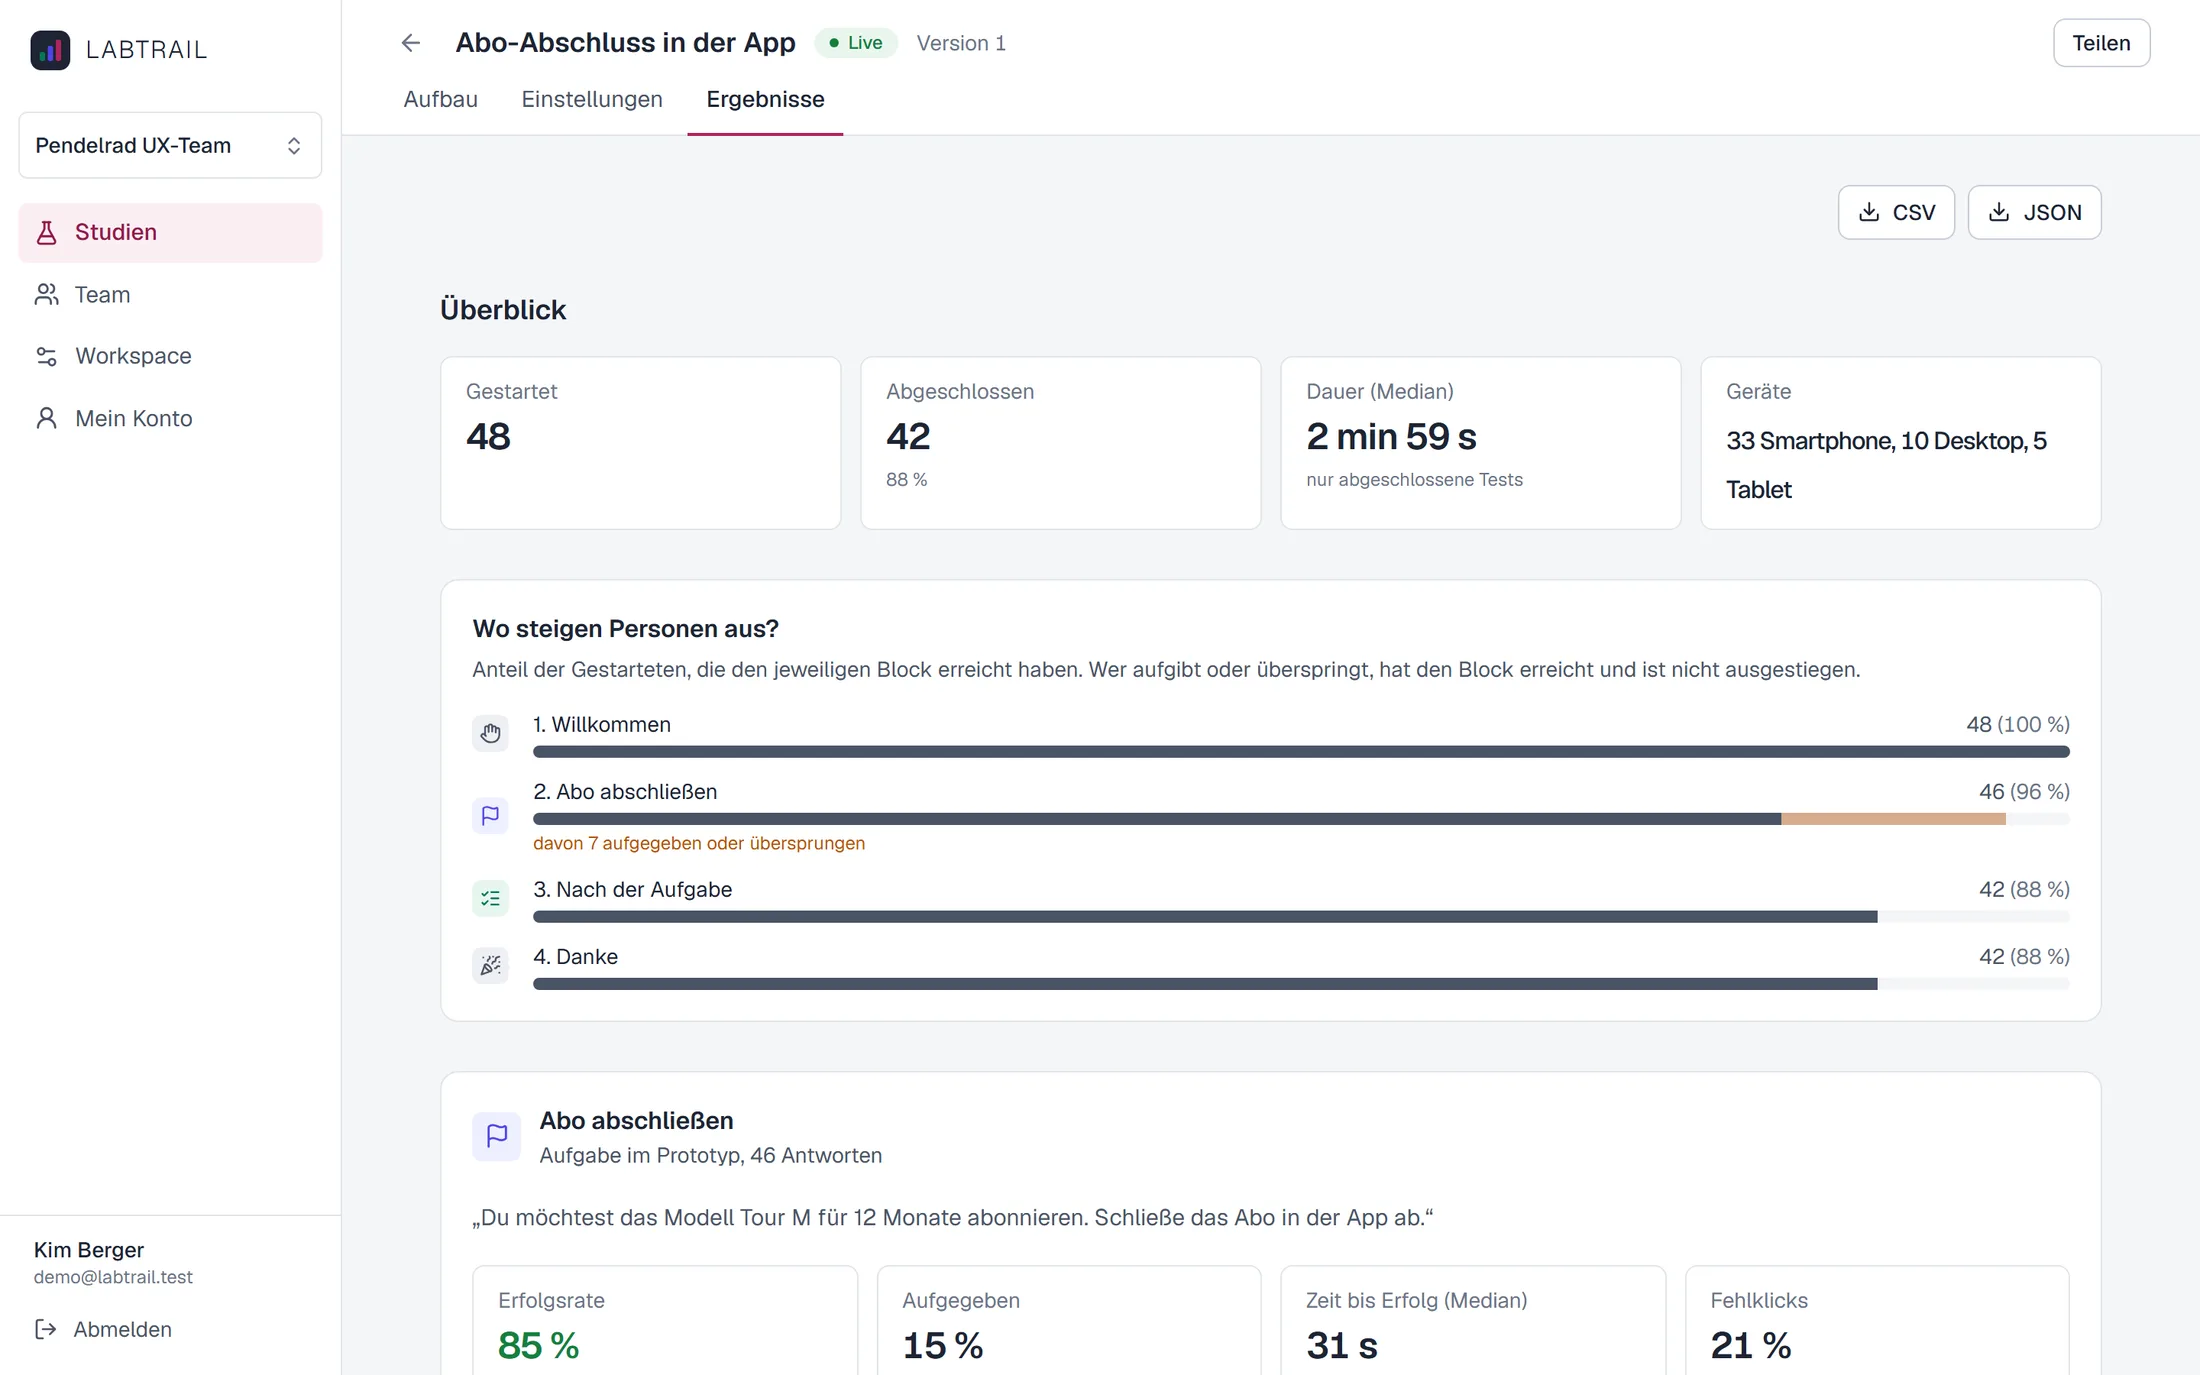
- Abo-Abschluss in der App: Prototyp-Test mit 48 Sitzungen, anschließend Fragen und SUS.
- Startseite und Kundenkonto: zwei Erster-Klick-Tests und NPS, 64 Sitzungen.
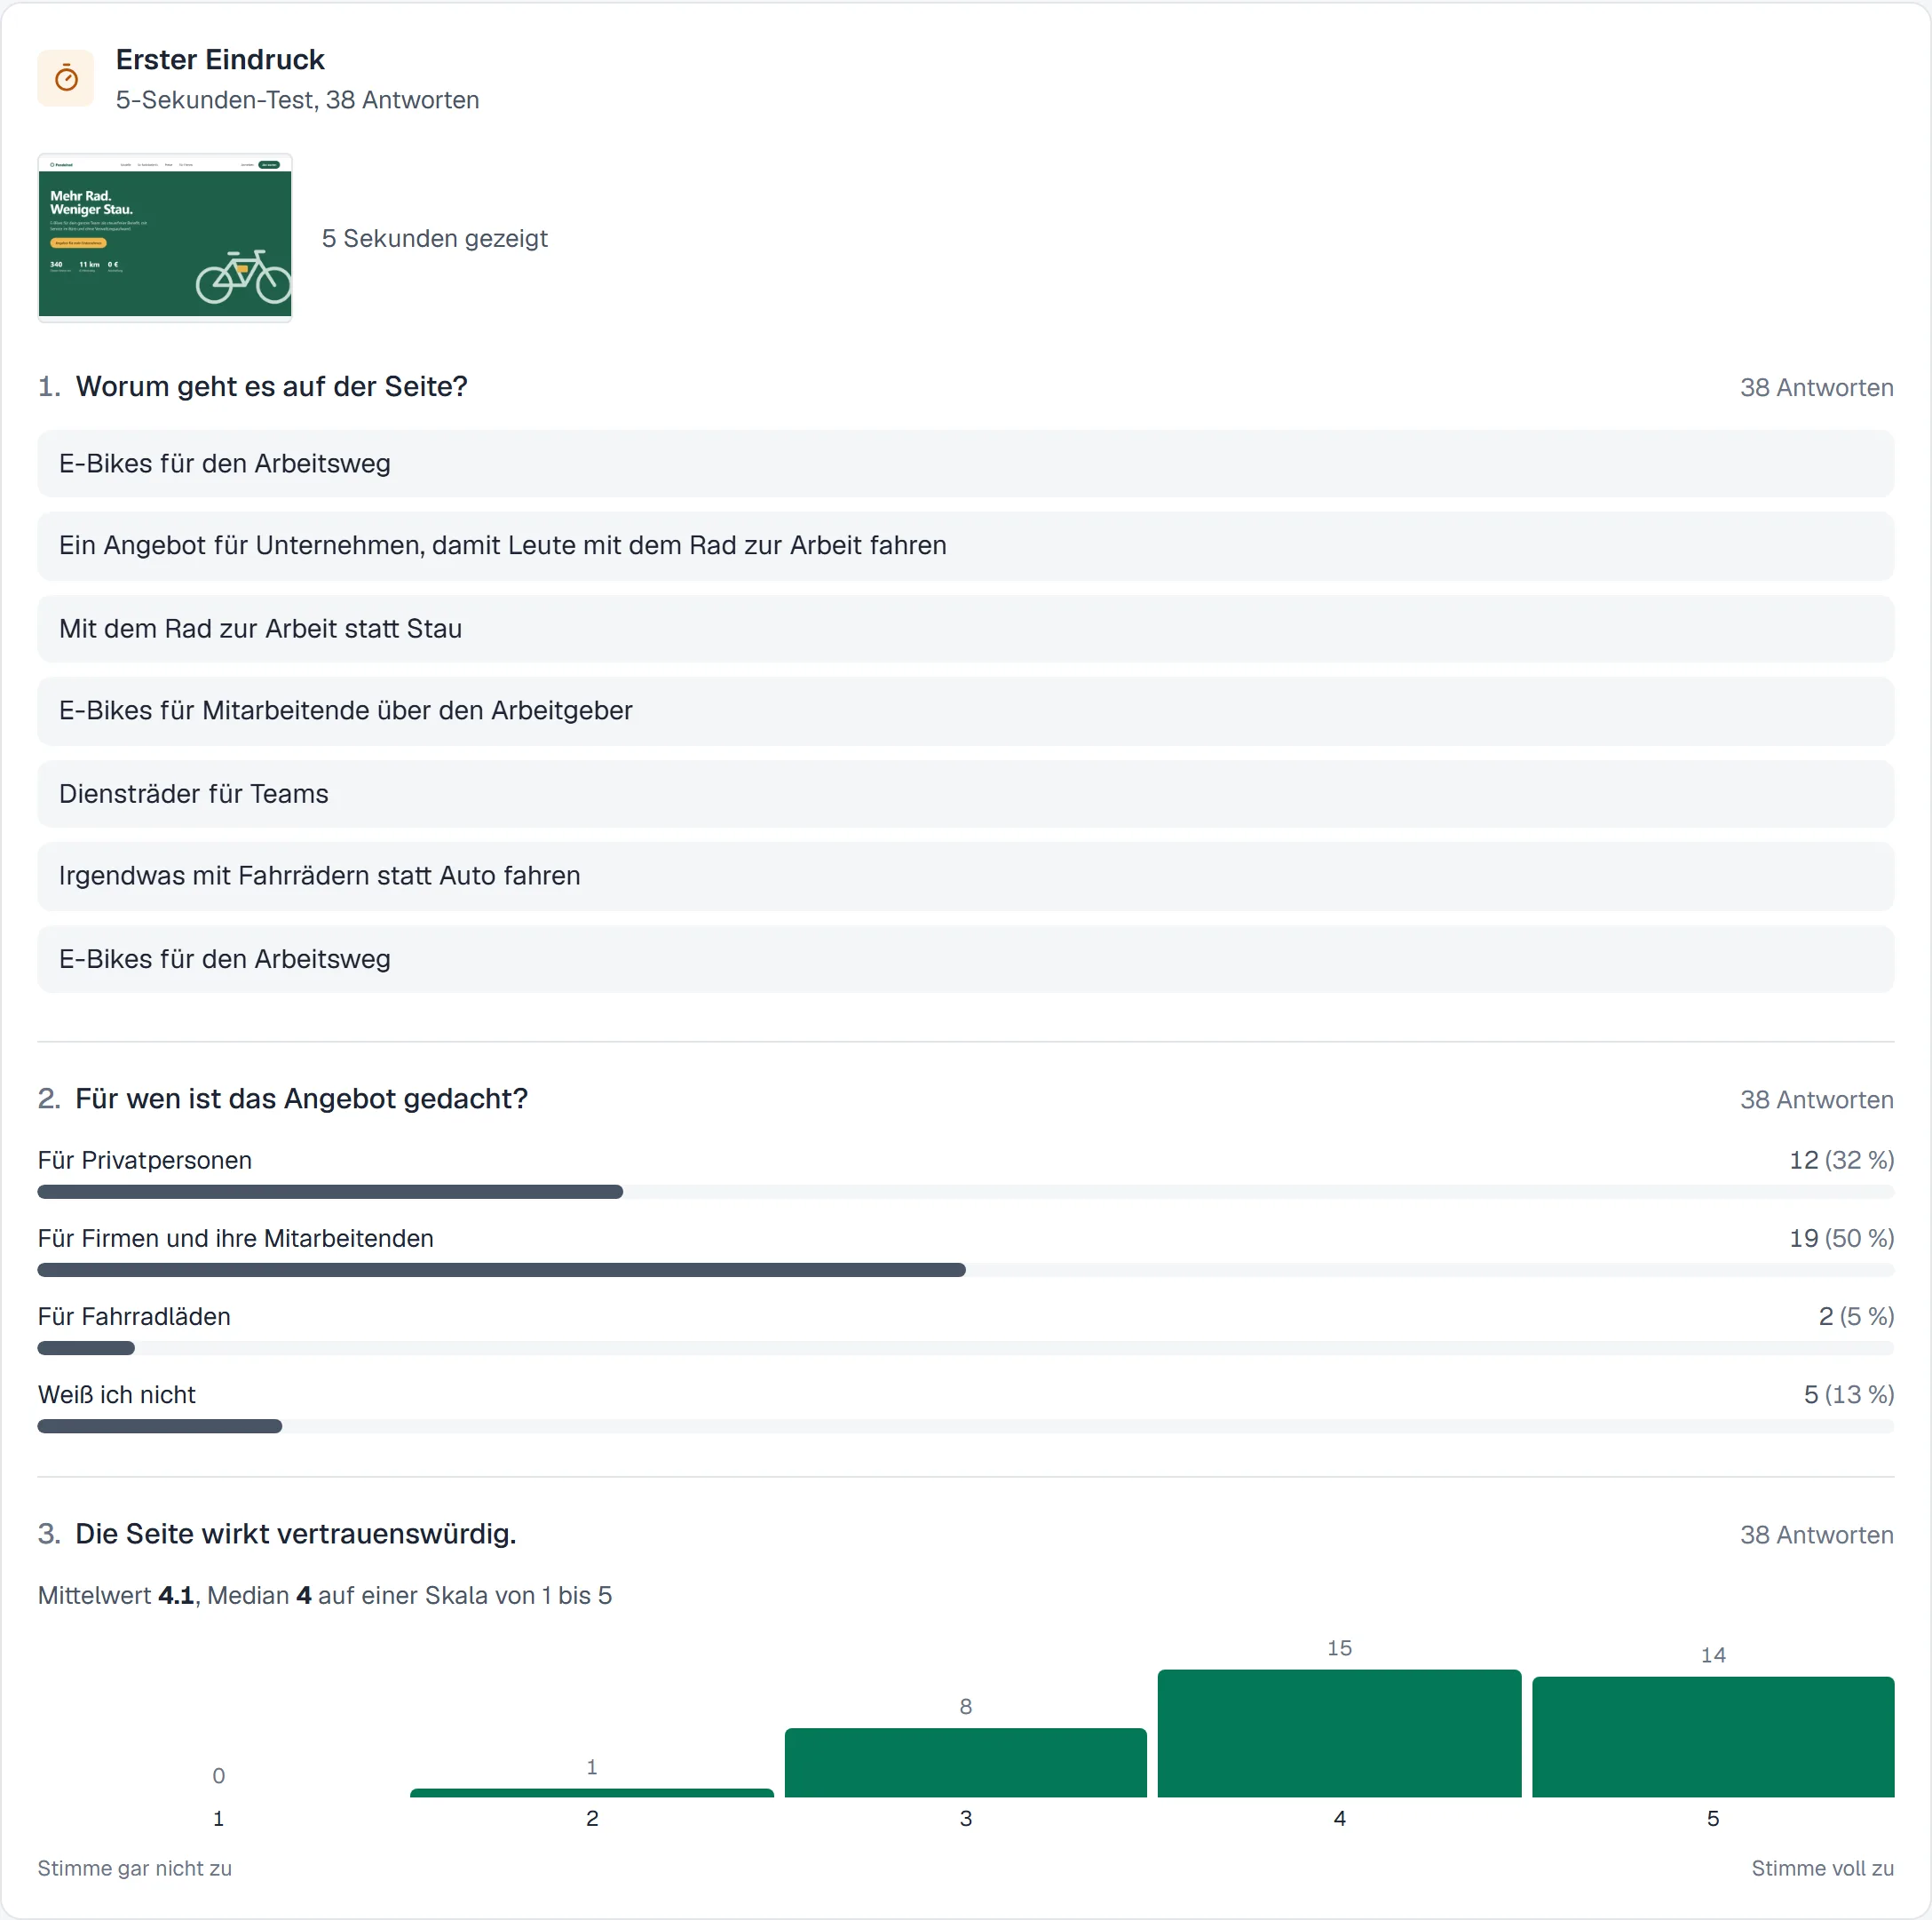
- Erster Eindruck einer Kampagnenseite: 5-Sekunden-Test mit 40 Sitzungen.
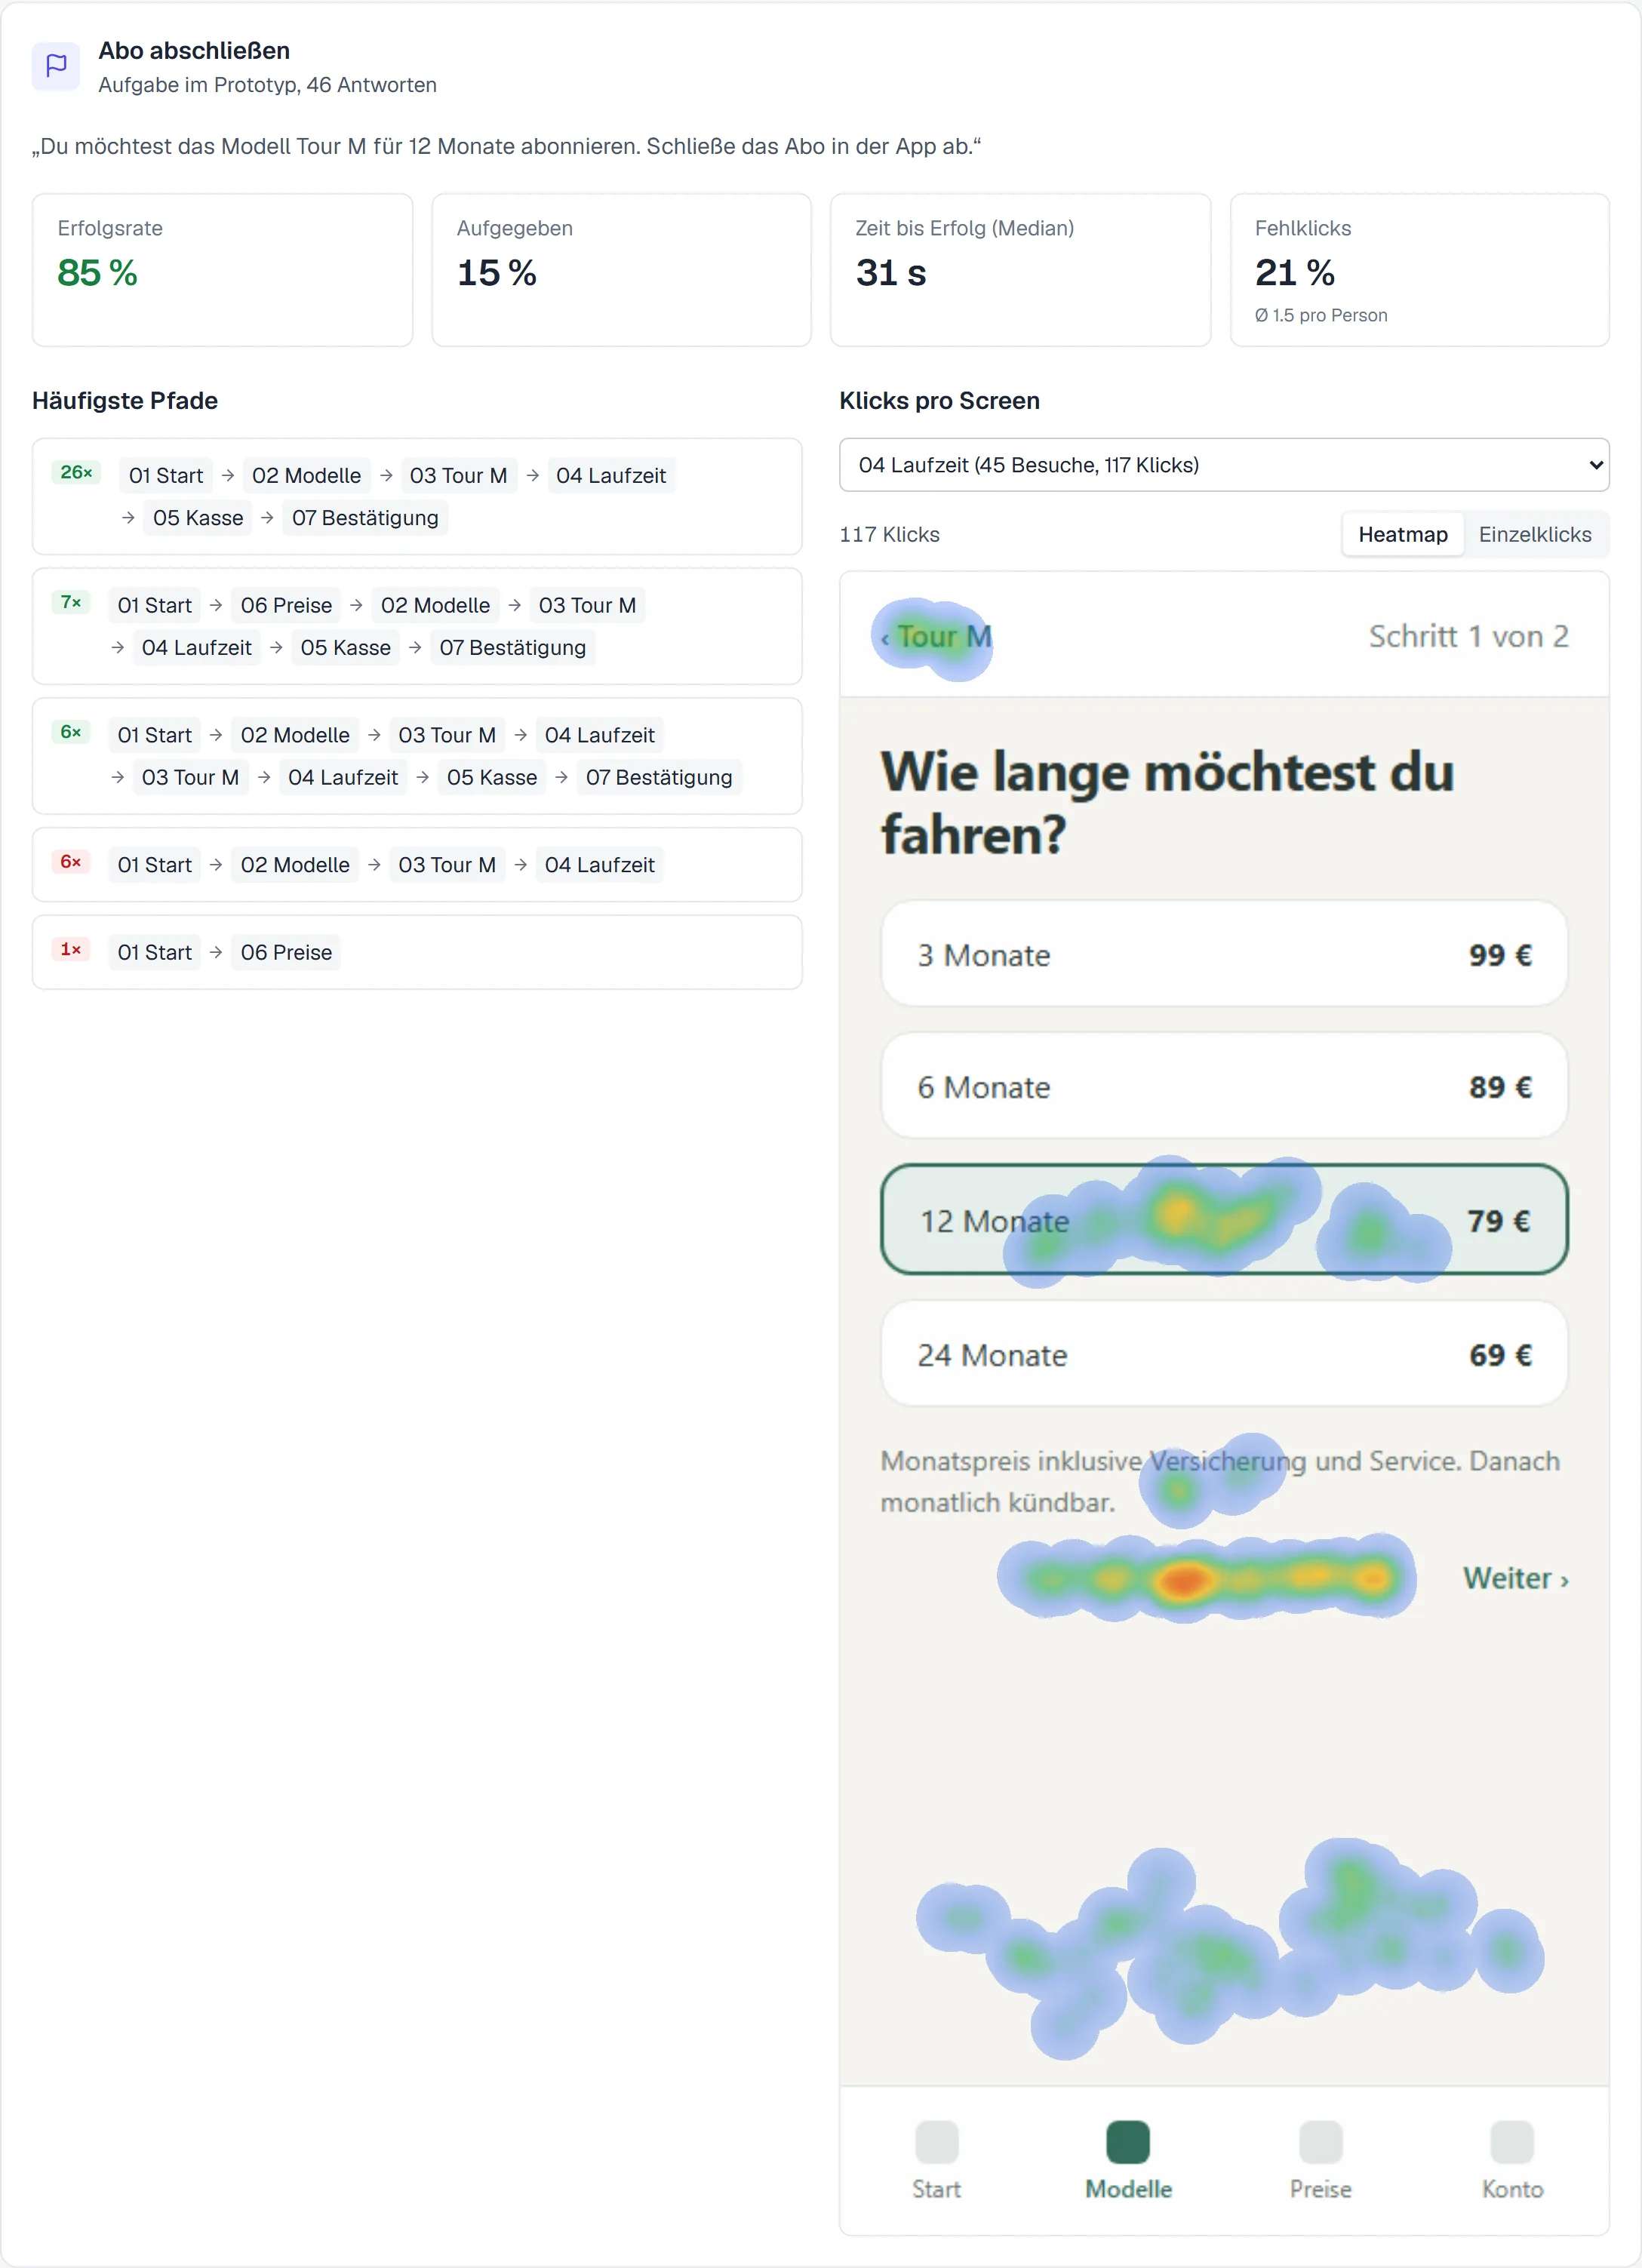
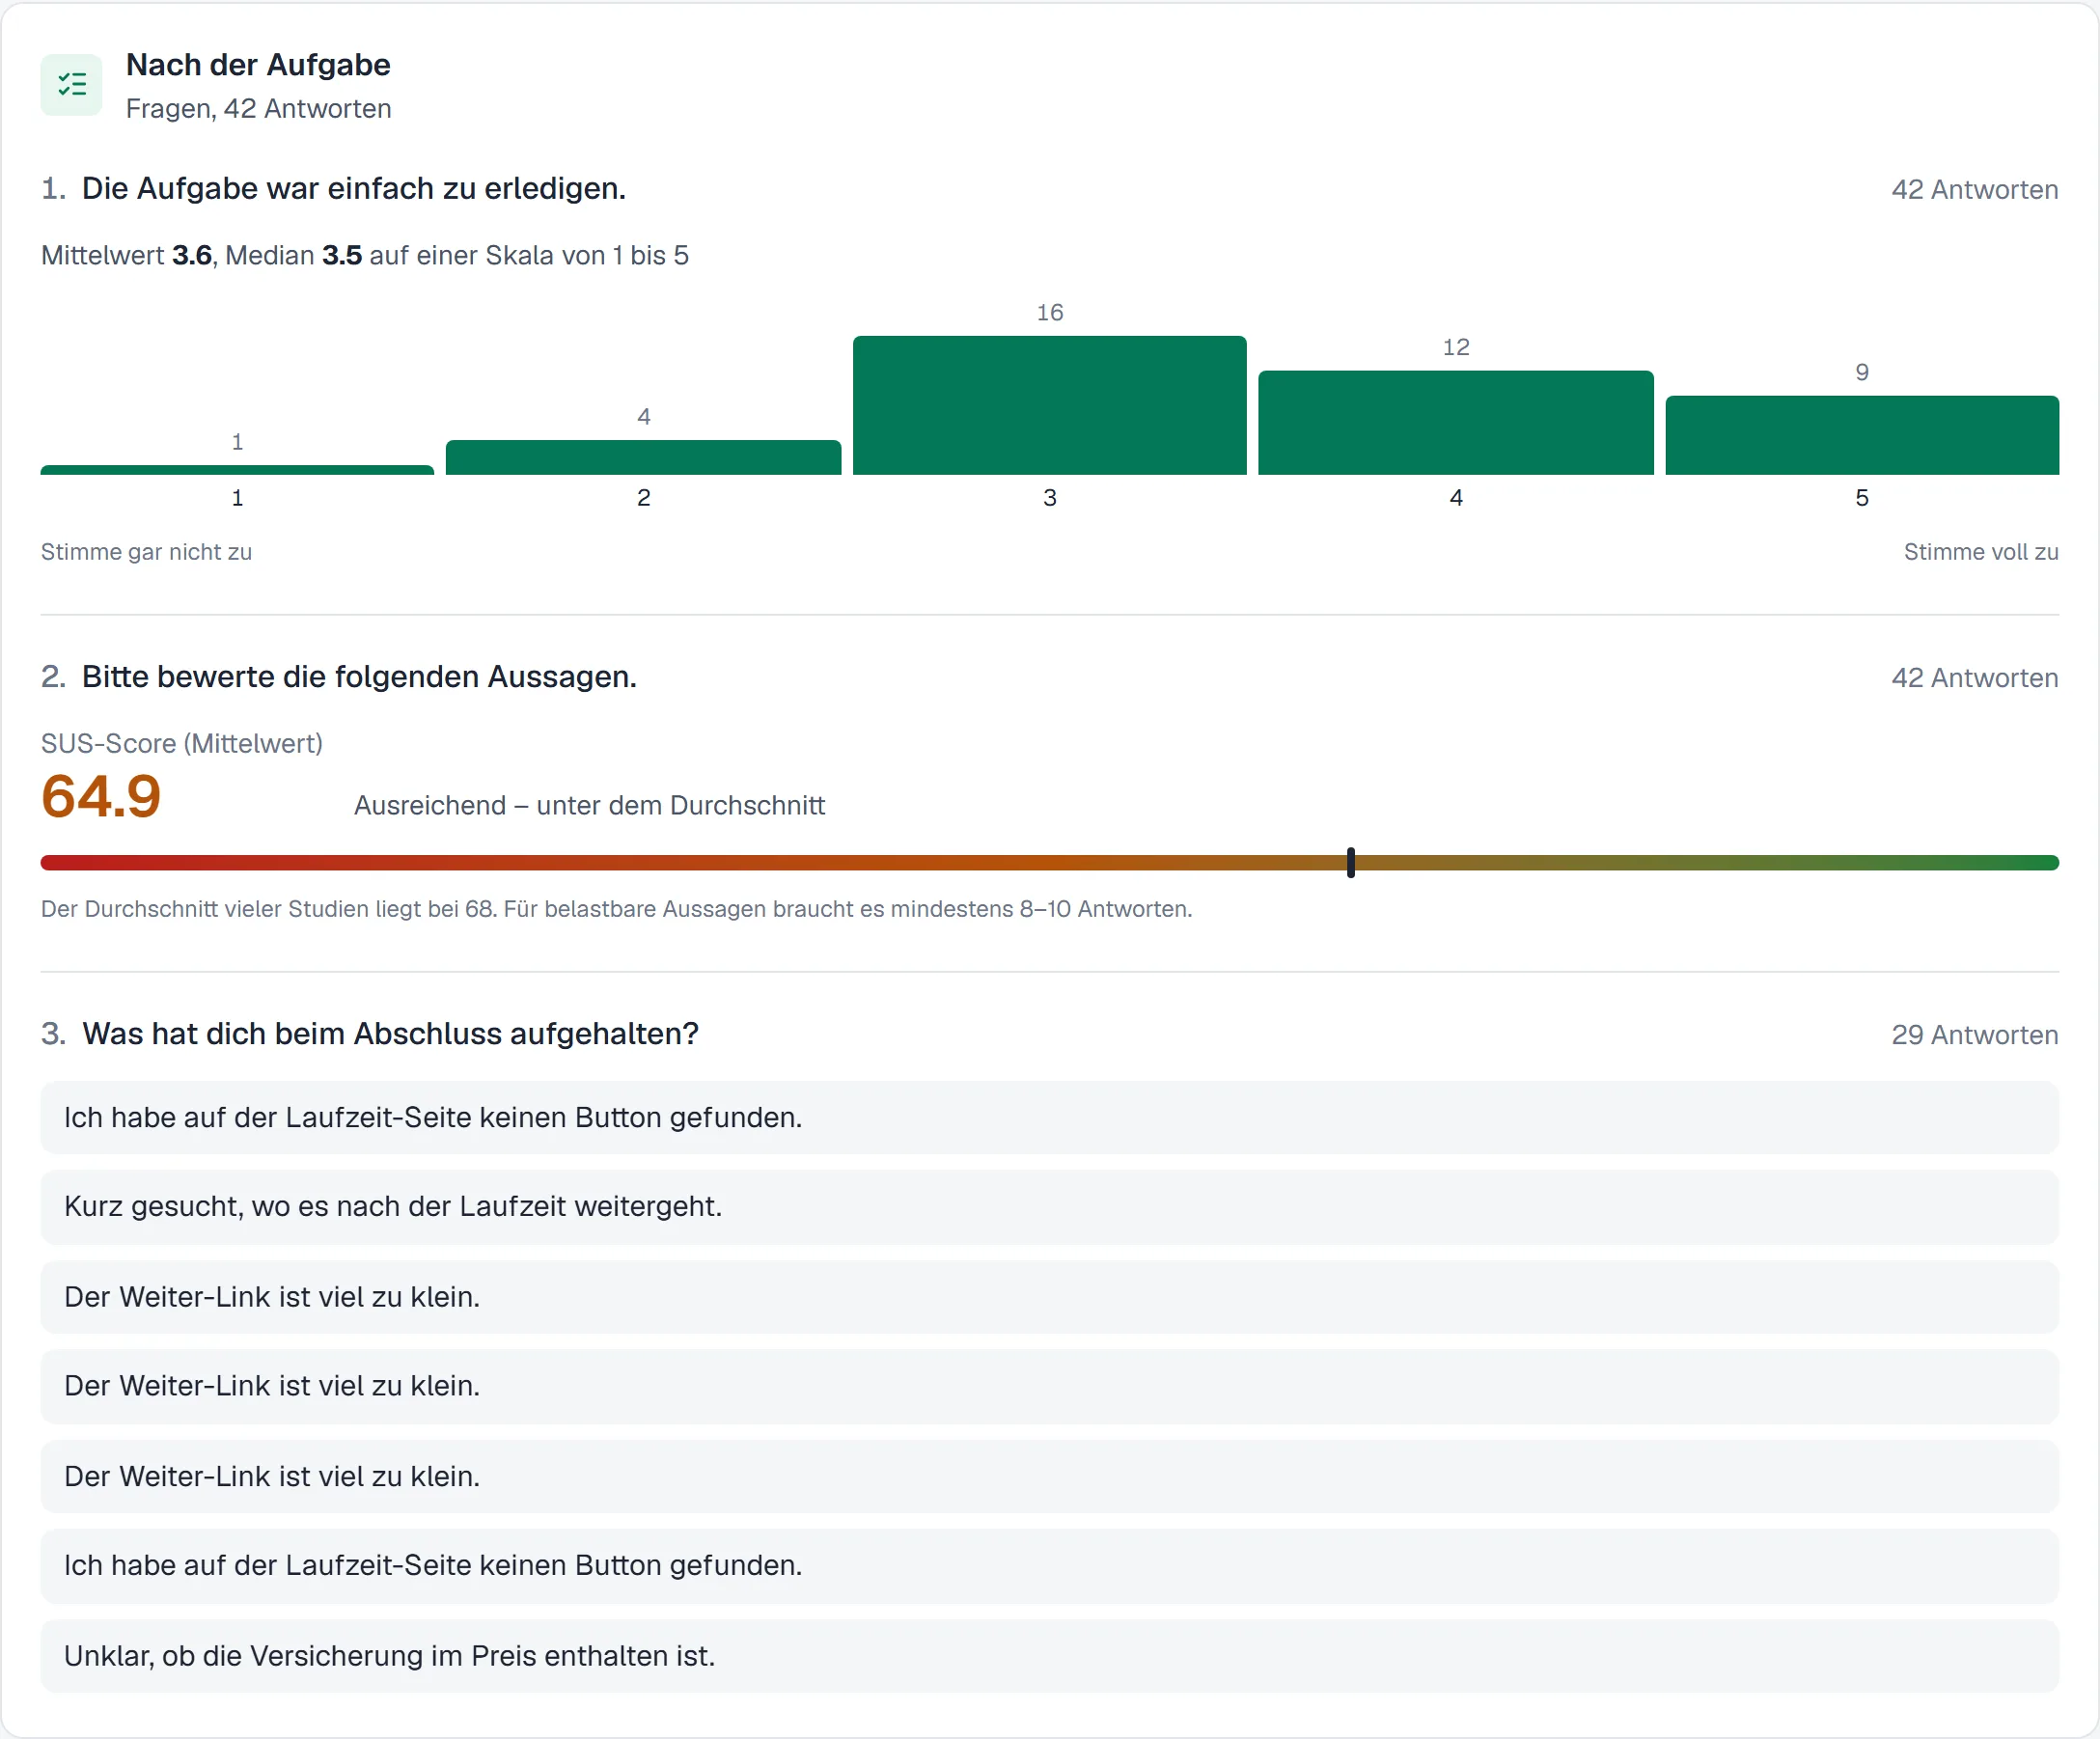
Die Screens sind selbst gestaltet. Die Testpersonen werden von einem Skript simuliert, das jede Sitzung über dieselben Wege einreicht wie echte Teilnehmende. Die Daten durchlaufen also dieselbe Prüfung und Auswertung. Das Skript enthält bewusst eine Schwachstelle: Auf dem Laufzeit-Screen ist „Weiter“ nur ein kleiner Textlink, wo viele einen Button erwarten.
Genau das zeigt die Auswertung, ohne dass man es suchen muss: 85 % schließen das Abo ab, aber Fehlklicks häufen sich unten auf dem Laufzeit-Screen, die meisten Abbrüche passieren dort, und die Freitexte nennen den Link. Zusammen ergibt das einen SUS von 64,9, knapp unter dem Durchschnitt.
Auch der 5-Sekunden-Test erzählt etwas: Die Kampagnenseite richtet sich an Arbeitgeber, aber nur die Hälfte erkennt das in fünf Sekunden.
Stand 8. November 2026
Ergebnis
Die Auswertung zeigt Trichter, Erfolgs- und Abbruchquoten, Pfade und Heatmaps pro Screen und exportiert als CSV und JSON. Betrieben wird die Plattform mit Docker Compose, PostgreSQL und S3-kompatiblem Speicher. Lokal läuft sie auch ohne Docker.
Geplant, Stand November 2026
Als Nächstes: Prototypen aus FigCraft
Labtrail spielt Prototypen bisher nur aus Figma ab. Damit ist Figma die einzige externe Verbindung der Plattform.
FigCraft von ArtCraft ist ein quelloffenes Design-Werkzeug mit Prototyping. Mit dem FigCraft-Server lässt es sich auf eigenen Servern betreiben. Beides befindet sich noch im Alpha-Stadium.
Mein Plan: Labtrail so erweitern, dass Studien künftig auch Prototypen aus FigCraft enthalten können. Testpersonen sähen den Prototyp dann ohne Anbieter von außen, und alle Daten blieben vollständig auf eigenen Servern. Mir ist bisher kein Testwerkzeug bekannt, das FigCraft-Prototypen unterstützt.
Zwei Dinge fehlen dafür in FigCraft noch: Prototypen lassen sich noch nicht per Link teilen, und Klicks und Screen-Wechsel werden noch nicht an andere Anwendungen gemeldet. Ich verfolge die Entwicklung des Servers und starte, sobald das möglich ist, wie bei Figma mit einem kleinen Spike. In Labtrail wird FigCraft dann eine zweite Prototyp-Quelle neben Figma, mit derselben Auswertung.
Grenzen und was ich als Nächstes täte
- Noch keine echte Studie auf dieser Seite: Die gezeigten Ergebnisse sind simuliert. Aussagekräftiger wäre eine echte Studie mit Testpersonen, deren Ergebnisse ich mit einem etablierten Tool vergleiche.
- Figma als einzige Prototyp-Quelle: Prototyp-Tests setzen einen Figma-Prototyp voraus. FigCraft ist geplant, andere Werkzeuge sind nicht angebunden.
- Weitere Methoden fehlen: Als Nächstes kommen Card Sorting und Tree Testing, danach Präferenz- und A/B-Tests sowie Sitzungsaufzeichnungen.
- Betrieb im Kleinen erprobt: Begrenzung von Login-Versuchen und Löschjob laufen pro Serverprozess. Für den Betrieb mit vielen Teams müsste das zentral laufen, und die öffentlichen Endpunkte der Teilnehmer-App brauchen eine eigene Begrenzung.
Was ich daraus mitnehme
Ein Testwerkzeug gestaltet man vor allem über seine Zahlen. Welche Antworten zählen, wer über Erfolg entscheidet und wie ehrlich ein Abbruch ausgewiesen wird, prägt die Designentscheidungen eines Teams stärker als jede Oberfläche. Und wer die Plattform selbst baut, bestimmt auch, wo die Daten der Testpersonen liegen.
Nächstes Projekt